JavaScript nei siti web: che cos’è e perché devi capire come arrivano i contenuti che pubblichi
Il tuo sito usa JavaScript, quasi sicuramente. Google lo esegue ma non clicca, gli assistenti AI non dicono se lo eseguono, gli agenti devono usarlo.
A meno che tu non faccia parte dell’1,1% del web, anche il tuo sito usa JavaScript.
È facile capire perché. Fa succedere cose mentre una pagina è aperta, cambia ciò che vedi e permette all’interfaccia di reagire senza ricaricare tutto ogni volta. Il problema nasce quando dal codice dipendono informazioni che devono trovare, leggere o usare anche le macchine.
La domanda diventa allora: che cosa gli hai affidato?
Che cos’è JavaScript
JavaScript è il linguaggio di programmazione che eseguono i browser per far reagire le pagine web alle azioni delle persone. Apre il menu, applica un filtro al catalogo, aggiorna il carrello, controlla i campi di un modulo prima dell’invio. Può anche chiedere dati nuovi a un server e inserirli nella pagina senza ricaricarla, fino a costruire intere applicazioni che vivono dentro una sola scheda del browser, nelle quali i contenuti e le funzioni cambiano mentre vengono utilizzati.
Può essere scritto dagli sviluppatori del sito oppure arrivare attraverso temi, plugin e servizi esterni. Gli script svolgono compiti diversi: alcuni gestiscono le interazioni, altri modificano gli elementi della pagina o recuperano informazioni che non erano presenti al caricamento iniziale. Un filtro, per esempio, può limitarsi a mostrare una parte dei prodotti già caricati oppure richiederne altri al server. Può essere eseguito anche sul server, contribuendo a generare la pagina prima che venga inviata al browser. Usare questo linguaggio, quindi, non significa necessariamente affidargli la costruzione dei contenuti nel browser.
Sul tuo sito JavaScript entra da più parti: il tema o il framework con cui il sito è stato sviluppato, i plugin, il codice scritto su misura e i servizi esterni che hai aggiunto nel tempo, come la chat, la mappa dei punti vendita o il sistema delle recensioni. Ognuno ha un compito diverso. Uno script di tracciamento registra le visite e lascia il contenuto com’è. Il TrustBox di Trustpilot, invece, legge gli attributi di un contenitore della pagina, apre al suo interno un riquadro separato e da lì un secondo script chiede ai server del fornitore recensioni, stelle e punteggio. Il visitatore le vede sulla tua pagina, eppure nel documento che il tuo server ha spedito non ci sono mai state.
A vista sono parti della stessa pagina, e l’occhio non ne distingue la provenienza. Dal punto di vista tecnico, invece, alcune informazioni stanno già nella risposta del server, altre esistono soltanto dopo che uno script è stato eseguito, altre ancora arrivano quando qualcuno fa qualcosa. È la distinzione che decide che cosa trovano Google, i programmi con cui gli assistenti AI recuperano le pagine e gli agenti che usano i siti per conto delle persone, perché ciascuno arriva alla pagina con capacità e condizioni sue, diverse da quelle del tuo browser.
HTML, CSS e DOM nella pagina che vedi
L’HTML contiene i testi e descrive la struttura del documento, con titoli, paragrafi, immagini, collegamenti, tabelle e moduli. Il CSS ne governa l’aspetto. JavaScript interviene sul comportamento, e può cambiare anche struttura e contenuto.
All’apertura di un indirizzo il browser riceve dal server una risposta che di norma contiene un documento HTML, lo interpreta e costruisce il DOM (Document Object Model), la rappresentazione della pagina, elemento per elemento, che gli script possono leggere e modificare. All’inizio il DOM riflette il documento ricevuto, a parte le correzioni che il browser applica da solo al markup non valido; poi ogni istruzione eseguita può allontanarlo dal documento, aggiungendo testi, sostituendo blocchi, cambiando il titolo.
Prendi due schede prodotto che a lavoro finito sembrano identiche. La prima arriva dal server con nome, descrizione e caratteristiche tecniche già scritte, e uno script recupera soltanto il prezzo da un servizio esterno. La seconda arriva con i contenitori vuoti e li riempie dopo il caricamento. Un programma che legge soltanto la risposta del server trova nella prima la descrizione del prodotto, nella seconda la struttura predisposta per ospitarla.
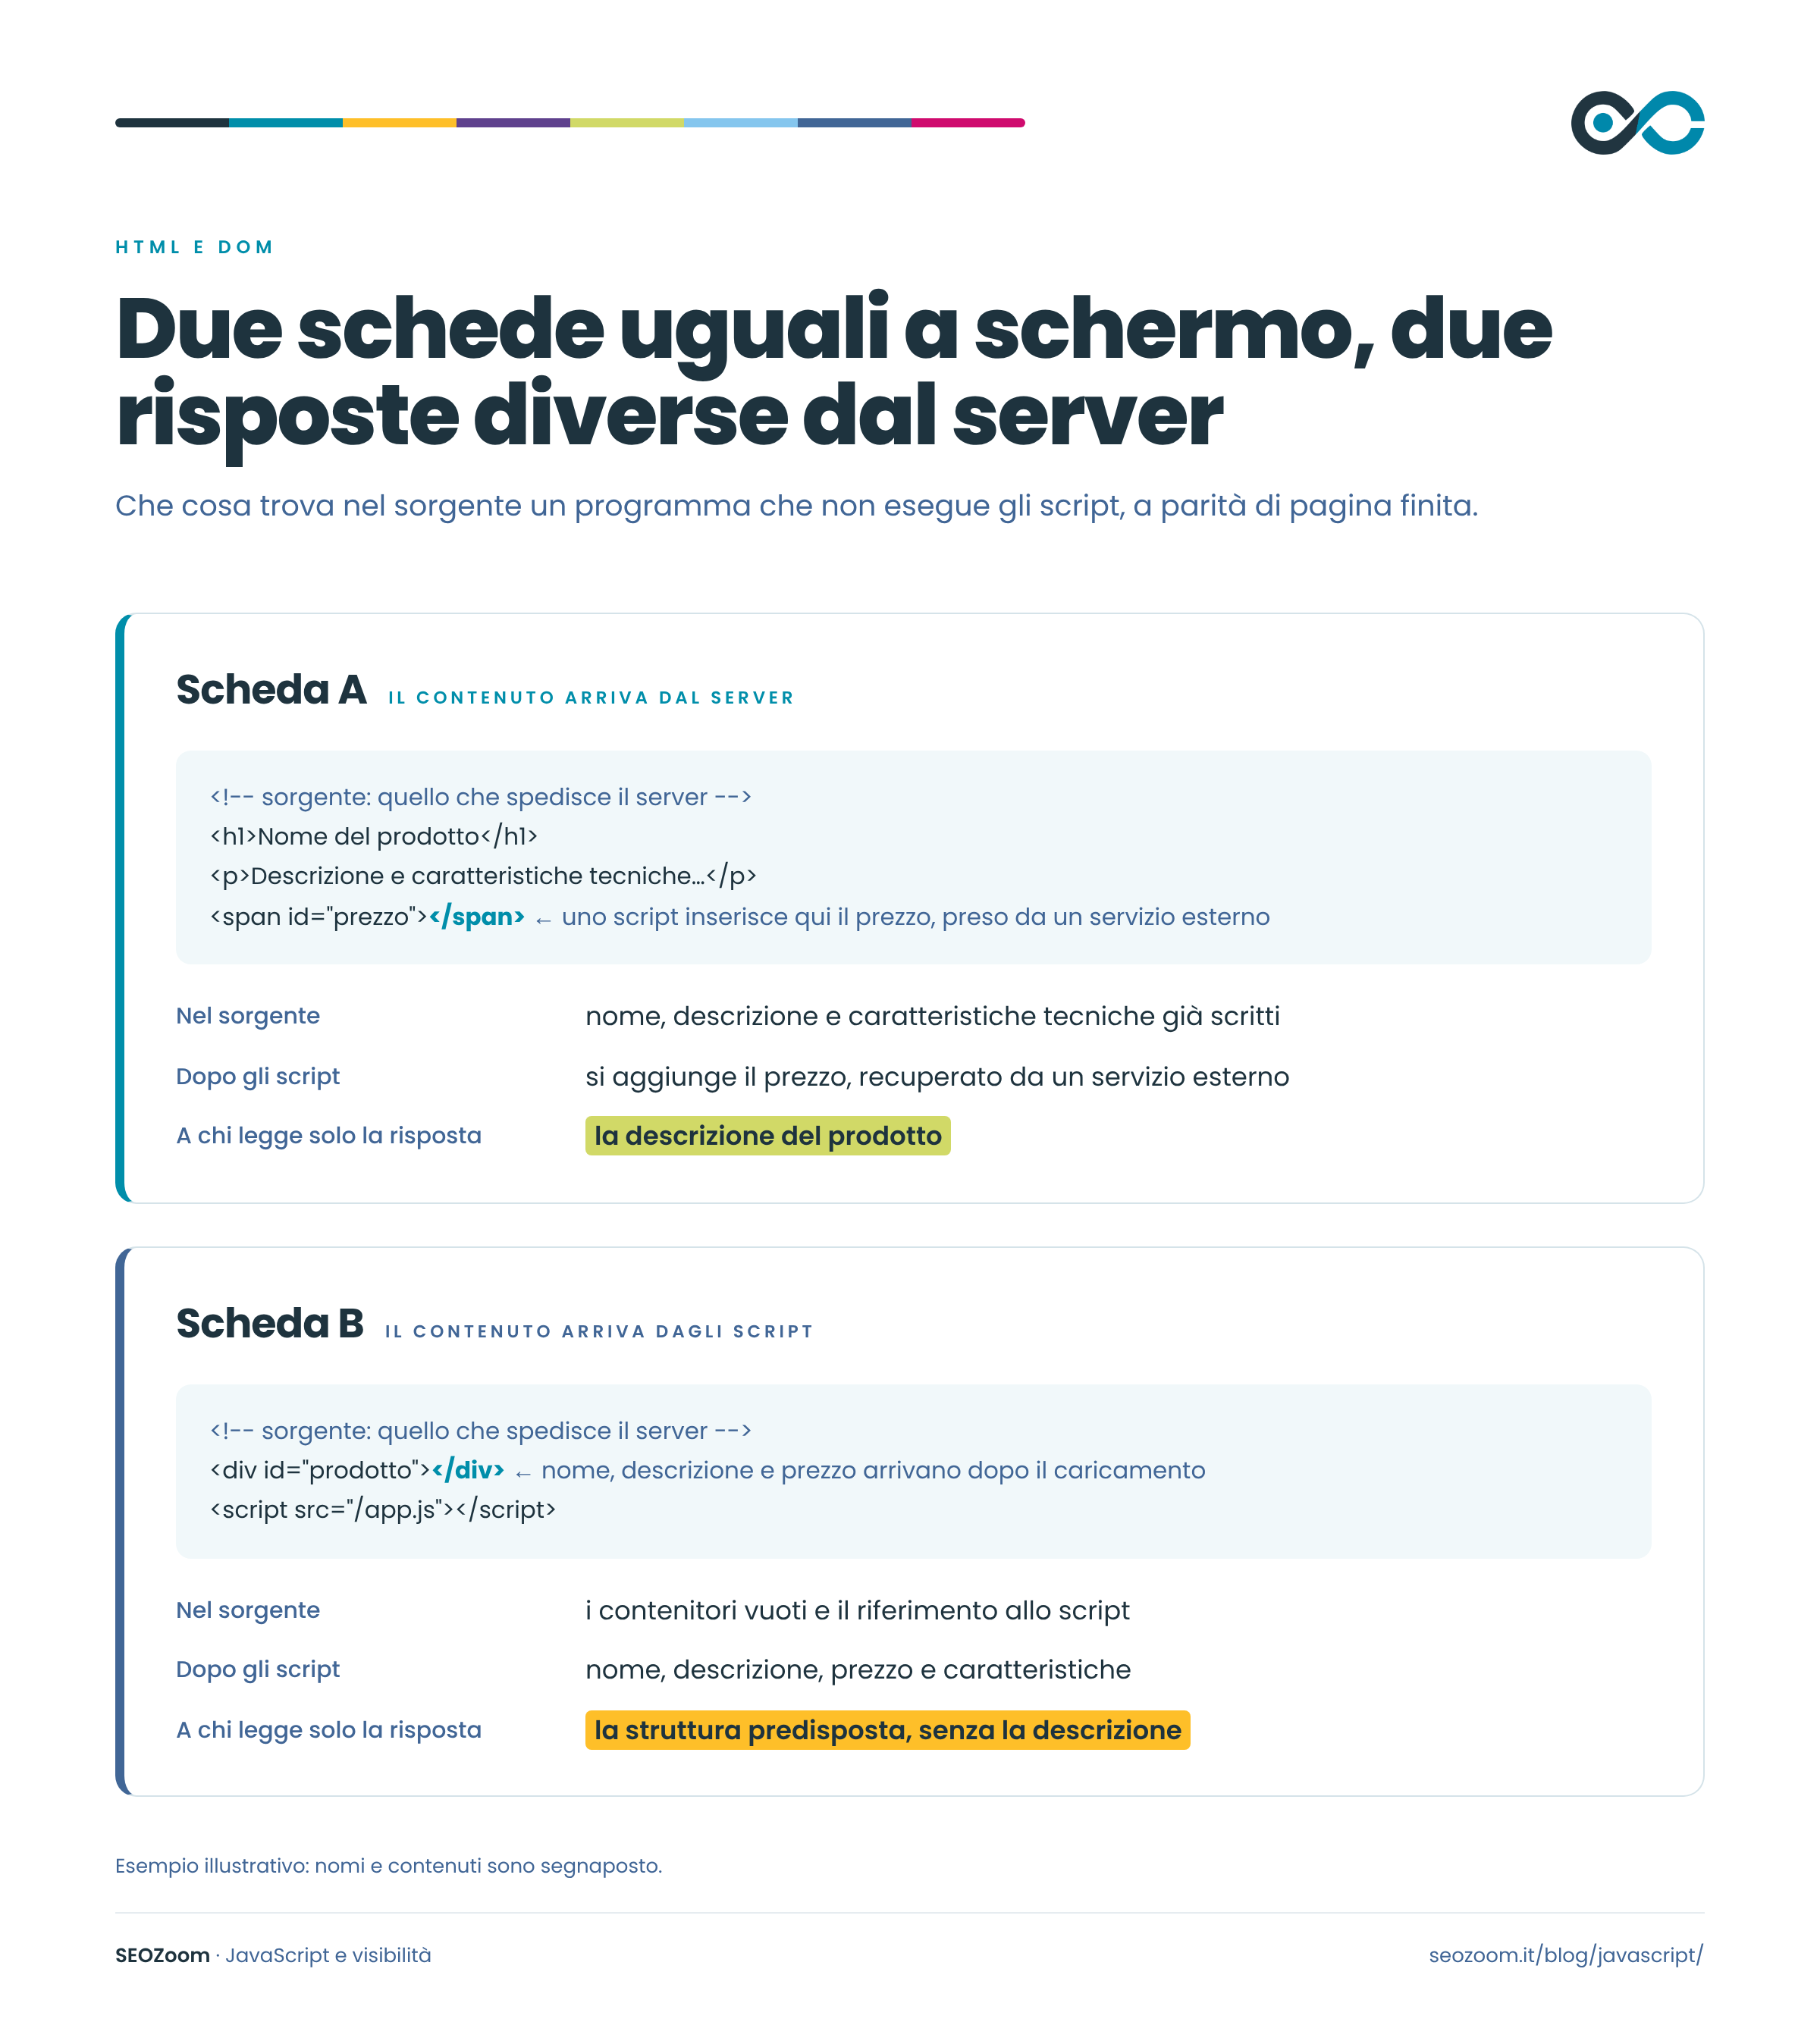
In Chrome vedi la differenza dal menu del tasto destro. «Visualizza sorgente pagina» mostra il codice sorgente, cioè l’HTML così come il server l’ha spedito; «Ispeziona» apre gli strumenti per sviluppatori sul DOM nel suo stato attuale. Un testo che trovi in Ispeziona e non nel sorgente è stato aggiunto durante l’elaborazione della pagina.
Un’informazione presente soltanto nel DOM non è un problema SEO in sé, perché Google esegue gli script e può leggerla. Il confronto ti dice da che cosa dipende quell’informazione, quali parti il server consegna già pronte e quali chiedono un passaggio in più a qualunque programma voglia leggerle.
Dove nasce l’HTML della pagina
Il progetto decide dove nasce l’HTML, e da quella scelta dipende quanto lavoro resta da fare dopo che la risposta è partita. Nel Client-Side Rendering (CSR) è il browser a costruire la pagina. Il server restituisce un documento con pochi elementi e i riferimenti agli script, e testo, navigazione e metadati arrivano con l’esecuzione. Con il Server-Side Rendering (SSR) l’applicazione compone l’HTML sul server, a ogni richiesta. Nella Static Site Generation (SSG) il sistema prepara il documento in anticipo, al momento della pubblicazione, e lo distribuisce così com’è a ogni visita. Il prerendering esegue l’applicazione al momento della pubblicazione e ne salva lo stato iniziale come HTML statico. Anche un sito WordPress con un tema classico consegna pagine composte sul server, perché è il server a elaborare il template e a restituire al visitatore l’HTML già pronto.
Le strategie convivono spesso nello stesso sito. Una scheda prodotto composta sul server può affidare a JavaScript l’aggiornamento della variante scelta; un sito editoriale distribuisce articoli già pronti e usa gli script per la ricerca interna e il menu. Il nome del framework, da solo, non dice dove nasce l’HTML. React, che si presenta come una libreria, Vue e Angular, che sono framework, funzionano con modalità di rendering diverse, e Next.js, Nuxt e il rendering lato server integrato in Angular servono a comporre le pagine sul server. Una single-page application (SPA), l’applicazione che cambia vista senza chiedere ogni volta un nuovo documento, può anch’essa consegnare dal server i contenuti della prima vista.
Nelle specifiche di un sito o di una nuova funzione, scrivere che una pagina «mostra» un’informazione lascia aperta la scelta che pesa di più. Quell’informazione può arrivare con la risposta del server, essere caricata dopo l’apertura della pagina oppure comparire soltanto quando qualcuno usa un comando. Sullo schermo il risultato può essere identico, mentre ai programmi che recuperano la pagina chiede operazioni diverse, e alcuni di quei programmi si fermano prima.
Il momento in cui un’informazione entra nella pagina
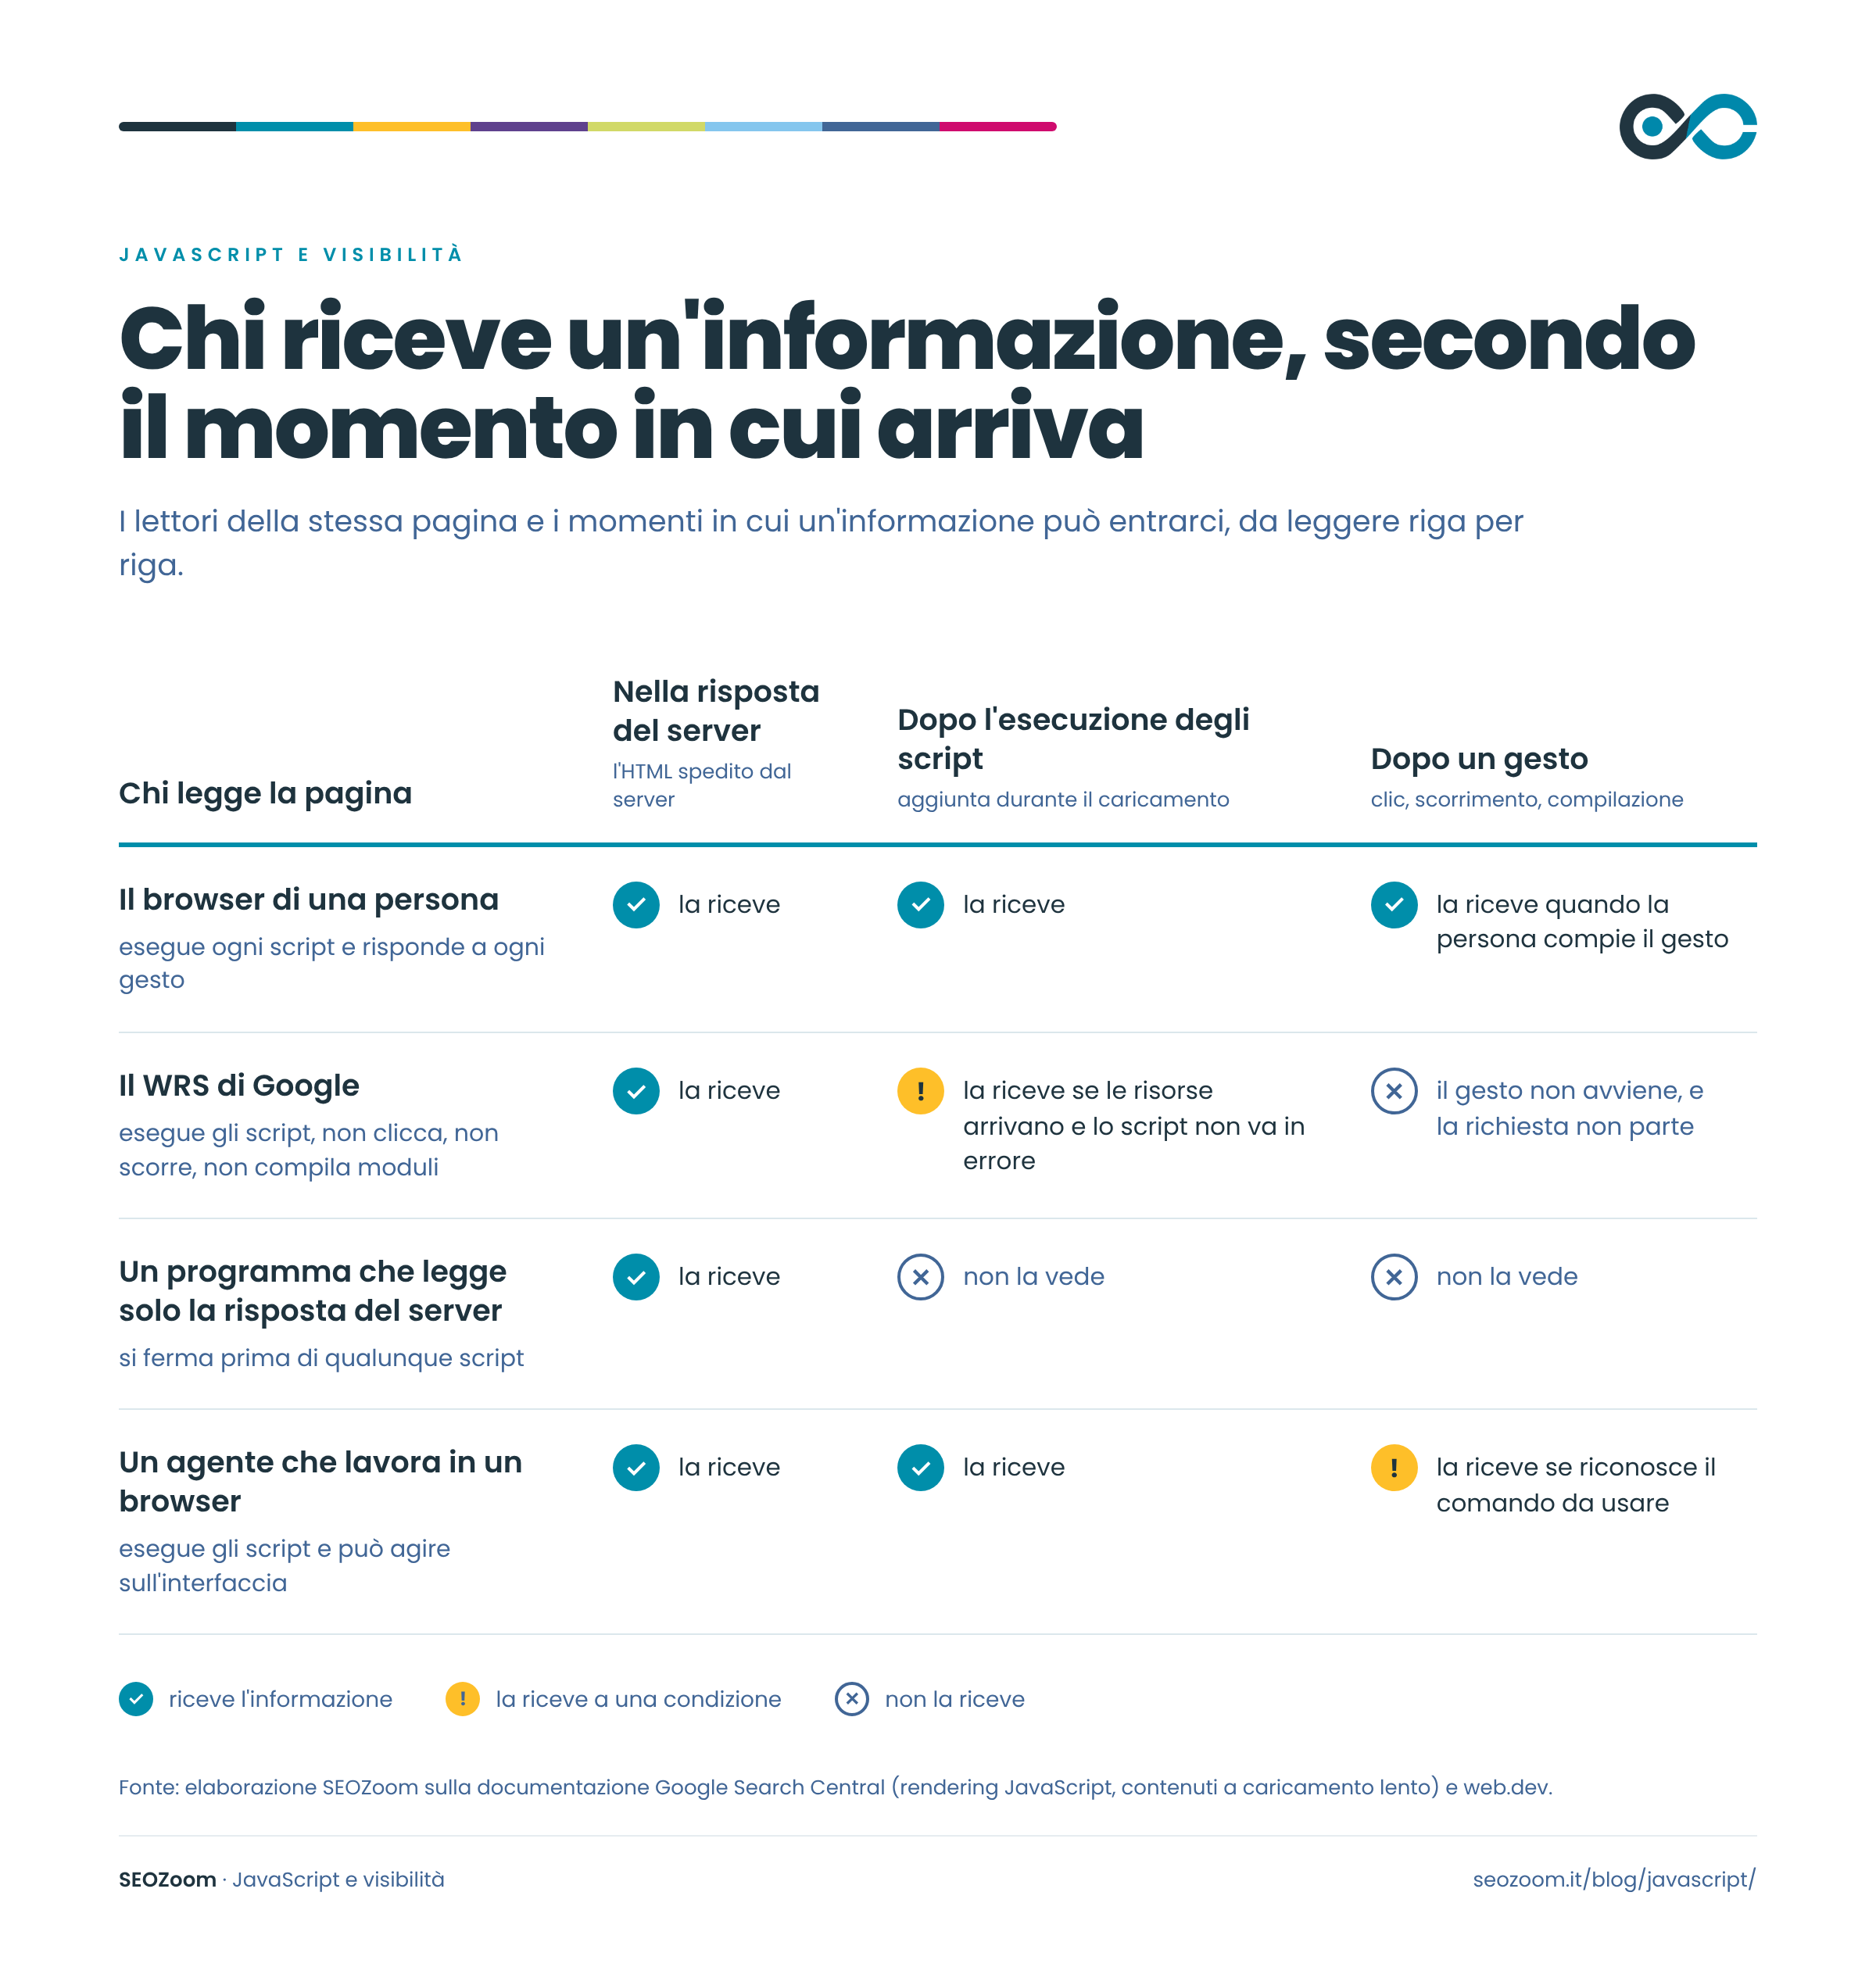
Uno script può cambiare la pagina mentre si carica, quando la persona interagisce con l’interfaccia, oppure in base a condizioni che valgono soltanto in quella sessione, come la località scelta, l’accesso all’area riservata o il consenso dato al banner dei cookie. Il momento in cui un’informazione arriva decide quali lettori la ricevono, più del fatto che sia JavaScript a portarla.
I lettori di una pagina, infatti, non vanno tutti fin dove arriva il tuo browser, che esegue ogni script e risponde a ogni gesto. Il Web Rendering Service (WRS) di Google esegue anch’esso gli script, ma non clicca, non scorre e non compila moduli. Un programma che scarica soltanto la risposta del server si ferma prima di qualunque script. Un agente che lavora in un browser può cliccare, a patto di capire dove. Una pagina costruita interamente nel browser può risultare leggibile al motore, e una pagina quasi completa già dal server può nascondere un’informazione importante dietro un pulsante che il WRS non preme mai.
Il testo che compare dopo un clic
Una sezione a fisarmonica, quella che apre la risposta quando tocchi la domanda, può avere il testo già nel documento, o riceverlo da uno script durante il caricamento, e affidare a JavaScript soltanto il compito di mostrarlo o nasconderlo. Oppure può chiedere il testo a un servizio al momento del clic, e fino ad allora nella pagina quel testo non esiste.
Il visitatore non nota alcuna differenza, mentre il WRS elabora la pagina senza toccare nulla. Le risposte già presenti nel documento, o aggiunte durante il caricamento, fanno parte dell’HTML renderizzato e sono a disposizione del motore anche a sezione chiusa; quelle richieste al clic in quell’HTML non entrano mai. Vale per le schede delle specifiche tecniche caricate quando le apri, per il pulsante «Leggi tutte le recensioni» che le scarica al momento, per qualunque contenuto che aspetta un gesto per essere richiesto.
Il caricamento differito funziona in modo simile. Il lazy loading rimanda il download di immagini e altre risorse finché non stanno per entrare nell’area visibile, con l’attributo loading="lazy" o con l’interfaccia IntersectionObserver del browser, e Google lo supporta. Gli elementi che partono soltanto con uno scorrimento eseguito dall’utente, o con un clic, rischiano di non arrivare al rendering, e la guida di Google sui contenuti a caricamento lento indica questi casi da correggere.
Sulle prestazioni il rinvio pesa in modi opposti. Rinviare le immagini lontane dall’apertura evita di scaricare file che la persona forse non vedrà mai; far aspettare l’immagine principale in cima alla pagina ritarda il Largest Contentful Paint (LCP), cioè proprio l’elemento che il browser dovrebbe mostrare per primo. Sul lazy loading la domanda utile riguarda che cosa rinvii e che cosa ne fa partire il caricamento.
Dati che arrivano da altri servizi
Una pagina che mostra informazioni aggiornate senza ricaricarsi, di solito, sta parlando con un altro servizio attraverso un’API (Application Programming Interface), l’interfaccia con cui due programmi si scambiano richieste e risposte secondo regole stabilite. Nel browser uno script, per esempio con l’istruzione fetch, chiama l’indirizzo del servizio, detto endpoint, riceve i dati e li inserisce nel DOM.
Succede in ogni genere di sito. Un’insegna con molti punti vendita prende sedi e orari dal gestionale, un portale di formazione chiede l’elenco aggiornato dei corsi alla piattaforma che li gestisce, una testata carica gli articoli correlati da un sistema separato, un ecommerce aggiorna prezzo e disponibilità dal magazzino. In tutti questi casi il contenuto dipende anche dal servizio interrogato. Una richiesta che fallisce, restituisce un errore o non si completa in tempo durante il rendering lascia la pagina senza le informazioni che avrebbe dovuto aggiungere, e il motore può elaborarne una versione incompleta.
Anche le condizioni della sessione pesano. Il tuo browser conserva cookie, preferenze e accessi, ricorda il negozio che hai scelto e il banner che hai già accettato. Un crawler arriva di norma senza questa storia, e per il renderer di Google l’assenza di memoria fra un rendering e l’altro è un comportamento documentato. Non vede un prezzo che compare soltanto dopo la scelta del punto vendita, né un contenuto che si sblocca con il consenso ai cookie, e incontra una versione della pagina diversa da quella che controlli tu. Un agente che lavora in un browser può invece avere una sessione aperta, anche con l’accesso fatto dalla persona per cui lavora. Il contenuto dietro il login resta comunque fuori dalla portata dei crawler, per scelta.

L’ostacolo, a volte, arriva prima dell’esecuzione. Un file JavaScript o un’API bloccati dal robots.txt, una regola del firewall o della CDN che respinge i crawler, un sistema anti-bot che chiede una verifica impediscono di scaricare le risorse da cui la pagina dipende. In quei casi il componente è a posto e non riceve ciò che gli serve, per cui la diagnosi deve guardare anche alle risorse.
Quanto pesano gli script sul browser
Il browser deve scaricare, analizzare ed eseguire ogni script, e la modalità di caricamento decide quanto gli costa, con effetti diretti sulla velocità del sito. Davanti a uno script classico, inserito nell’HTML senza attributi, il browser si ferma, lo scarica e lo esegue prima di continuare a leggere il documento. Con async lo scaricamento procede in parallelo e l’esecuzione parte appena il file è disponibile, senza un ordine garantito; con defer l’esecuzione aspetta la fine della lettura del documento e rispetta l’ordine degli script. I moduli JavaScript sono differiti in partenza.
Gli script possono poi occupare a lungo il thread principale del browser e ritardare la risposta ai comandi, il fenomeno che l’Interaction to Next Paint (INP) misura. Pesano sull’LCP quando ritardano la comparsa del contenuto principale e sul Cumulative Layout Shift (CLS) quando inseriscono elementi che spostano quelli già visibili. Sono gli indicatori dei Core Web Vitals. PageSpeed Insights li mostra pagina per pagina, con i dati reali degli utenti di Chrome dove disponibili, e Lighthouse ne riproduce una parte in laboratorio.
Costo di esecuzione e disponibilità delle informazioni sono proprietà separate, e le misure delle prestazioni descrivono soltanto la prima. Una pagina veloce può dipendere dagli script per il testo che conta, e una pagina con tutto il contenuto nell’HTML può far lavorare il browser troppo a lungo prima di diventare utilizzabile.
Quello che Google fa con il JavaScript del tuo sito
Googlebot scarica l’URL, analizza la risposta ed estrae i collegamenti presenti nell’HTML. Le pagine idonee entrano in una coda di rendering, dove possono restare pochi secondi o più a lungo, secondo le risorse disponibili. Il WRS, basato su una versione di Chromium senza interfaccia grafica, esegue gli script e produce l’HTML renderizzato, che il motore analizza di nuovo per trovare altri collegamenti e usa per l’indicizzazione.
Eseguire JavaScript non garantisce il risultato. Una richiesta API può fallire, una risorsa necessaria può essere bloccata, il codice può incontrare un errore prima di aggiungere le informazioni previste. E una pagina renderizzata correttamente può comunque restare fuori dall’indice, perché il rendering è un passaggio del processo e non la decisione finale.
A marzo 2026 Google ha tolto dalle nozioni di base sulla SEO per JavaScript una sezione sull’accessibilità, spiegando che caricare contenuti con JavaScript non rende più difficile il lavoro della Ricerca. Nella stessa documentazione il rendering lato server e il prerendering sono indicati come una buona soluzione, perché non tutti i bot possono eseguire JavaScript. Una pagina costruita nel browser, quindi, a Google arriva; le ragioni per servire i contenuti dal server riguardano gli altri programmi che la leggono, quelli a cui si riferisce quella raccomandazione.
Le condizioni in cui lavora il WRS
Il WRS lavora senza memoria. Fra un rendering e l’altro svuota cookie, local storage e session storage, e rifiuta le richieste di permesso, come quella per la geolocalizzazione o le notifiche. Un contenuto che dipende da una preferenza salvata o da un permesso concesso arriva a Google nella versione che vede un visitatore alla prima apertura.
Googlebot non scarica le risorse bloccate dal robots.txt, siano file JavaScript, fogli di stile o API, e al renderer manca tutto quello che avrebbero prodotto. Per ogni file, poi, Googlebot scarica i primi 2 MB e tratta il resto come mai arrivato. Per una normale pagina HTML è una soglia lontana, mentre un pacchetto di script molto voluminoso o un documento che incorpora grandi quantità di dati possono avvicinarla.
Googlebot conserva inoltre in cache le risorse in modo aggressivo, e il WRS può ignorare le intestazioni che ne regolano la durata. Può succedere che il server restituisca l’HTML nuovo mentre il rendering usa ancora lo script vecchio. Il rimedio è il fingerprinting, un nome di file che incorpora un’impronta del contenuto, come main.2bb85551.js, e che cambia a ogni modifica, così Googlebot scarica il file aggiornato come una risorsa mai vista. Spiega anche perché un problema possa comparire o sparire in ritardo rispetto al rilascio che lo ha causato.
I collegamenti che Google riesce a seguire
Per scansionare una pagina Googlebot deve conoscerne l’indirizzo, e lo ricava da collegamenti, sitemap e altre fonti. Dall’HTML della risposta estrae i link durante la scansione; dall’HTML renderizzato estrae anche quelli che uno script ha aggiunto. Un collegamento creato con JavaScript, quindi, funziona come gli altri quando produce un elemento <a> con un attributo href che contiene un URL risolvibile. Un percorso di link interni disegnato bene vale per Google quando il codice lo dichiara con collegamenti veri.
| Markup del collegamento | Che cosa ne ricava Google |
|---|---|
<a href="/sedi/milano/">Sede di Milano</a> |
Un collegamento da seguire, con il suo testo di ancoraggio |
<a href="/sedi/milano/" onclick="apriSede()"> |
Un collegamento da seguire: lo script gestisce il clic, l’indirizzo resta nell’href |
<a onclick="vai('/sedi/milano/')"> |
Un URL che Google non estrae in modo affidabile, perché manca l’href |
<a href="javascript:vai('/sedi/milano/')"> |
Un URL che Google non estrae in modo affidabile, perché l’href contiene un’istruzione |
<span href="/sedi/milano/"> |
Un URL che Google non estrae in modo affidabile, perché l’elemento non è un link |
<a routerLink="/sedi/milano"> |
Una forma che Google non segue in modo affidabile; Angular può aggiungere l’href nel DOM finale, e lo verifichi nell’HTML renderizzato |
<div onclick="vai('/sedi/milano/')"> |
Un riquadro cliccabile con il mouse, senza un collegamento dichiarato |
Il riquadro costruito con <div onclick> porta a destinazione con il clic, quando lo script funziona, e per il motore è una scatola senza indirizzo. E crea problemi anche alle persone che navigano con la tastiera, perché un elemento generico non riceve il focus e non risponde a Invio finché lo sviluppatore non gli aggiunge un ruolo, l’attributo tabindex e la gestione dei tasti. Un <a href> risolve entrambe le cose con il comportamento che l’HTML gli dà in partenza.
Le viste che meritano un URL
Una categoria che mostra i primi prodotti e aggiunge i successivi con il pulsante «Carica altri» genera i collegamenti alle schede seguenti soltanto dopo il clic. Il WRS non preme il pulsante, e dal rendering della categoria quei collegamenti non arrivano; le schede possono comunque essere note a Googlebot per altre strade, come la sitemap o i link da altre sezioni del sito. Per i contenuti suddivisi in più pagine Google indica nelle sue istruzioni sulla paginazione URL stabili per ogni pagina, del tipo ?page=2, collegati fra loro con link veri. Lo scorrimento infinito può restare per le persone, a patto di non essere l’unica strada verso le risorse.
I filtri sono un caso diverso. La combinazione che una persona seleziona in un catalogo può restare uno stato dell’interfaccia, e lasciare le combinazioni fuori dall’indice è una scelta legittima. Sui cataloghi grandi, anzi, le query string generate dai filtri possono anche moltiplicare gli indirizzi e assorbire crawl budget. Una combinazione che risponde a una ricerca reale, che il progetto ha deciso di presidiare, chiede una pagina vera, con un indirizzo stabile e un posto nella navigazione. La decisione nasce dalla struttura del catalogo e dalla domanda che vuoi intercettare; JavaScript decide soltanto se quell’indirizzo esiste.
Nelle single-page application ogni vista che deve funzionare come pagina autonoma ha bisogno di un URL suo. La History API del browser aggiorna l’indirizzo senza ricaricare il documento, ed è la soluzione raccomandata al posto dei frammenti come #/prodotti, che Googlebot non risolve in modo affidabile. Il server, poi, deve saper rispondere quando un link esterno o un crawler richiede direttamente quell’indirizzo, restituendo la vista giusta e non l’errore o il guscio vuoto dell’applicazione.
Title, canonical e noindex scritti dagli script
JavaScript può impostare o cambiare anche le informazioni che di solito associ all’intestazione della pagina: title, meta description, canonical, direttive robots, dati strutturati. Google accetta title e meta description impostati dagli script. Il rischio nasce nelle applicazioni che cambiano vista senza un nuovo documento, dove il contenuto si aggiorna e title e canonical sono ancora quelli della vista precedente, e il motore riceve indicazioni che non corrispondono alla risorsa che sta elaborando.
Per il rel canonical il posto migliore è l’HTML. Google sconsiglia di usare JavaScript per sostituire un canonical già presente nel documento con un URL diverso; quando il valore si può calcolare soltanto nel browser, la strada è ometterlo dall’HTML e lasciarlo inserire allo script. Due valori diversi, uno scritto dal template e uno iniettato da un tag manager, mettono Google davanti a indicazioni in contrasto. Puoi dichiarare il canonical anche nell’intestazione HTTP Link, e l’hreflang anche nella sitemap, canali che non dipendono dall’esecuzione degli script. La sola presenza di un URL nella sitemap, invece, per Google è un segnale di canonicità più debole di un rel canonical esplicito.
Con il noindex conta il verso della modifica. Google può saltare il rendering quando trova la direttiva nell’HTML iniziale, e lo script incaricato di toglierla per rendere indicizzabile la pagina rischia di non partire. Aggiungere invece il noindex con JavaScript durante il rendering per escludere una vista che rappresenta una pagina inesistente è una pratica documentata. Le direttive del meta tag robots, insomma, appartengono al punto in cui nasce la risposta.
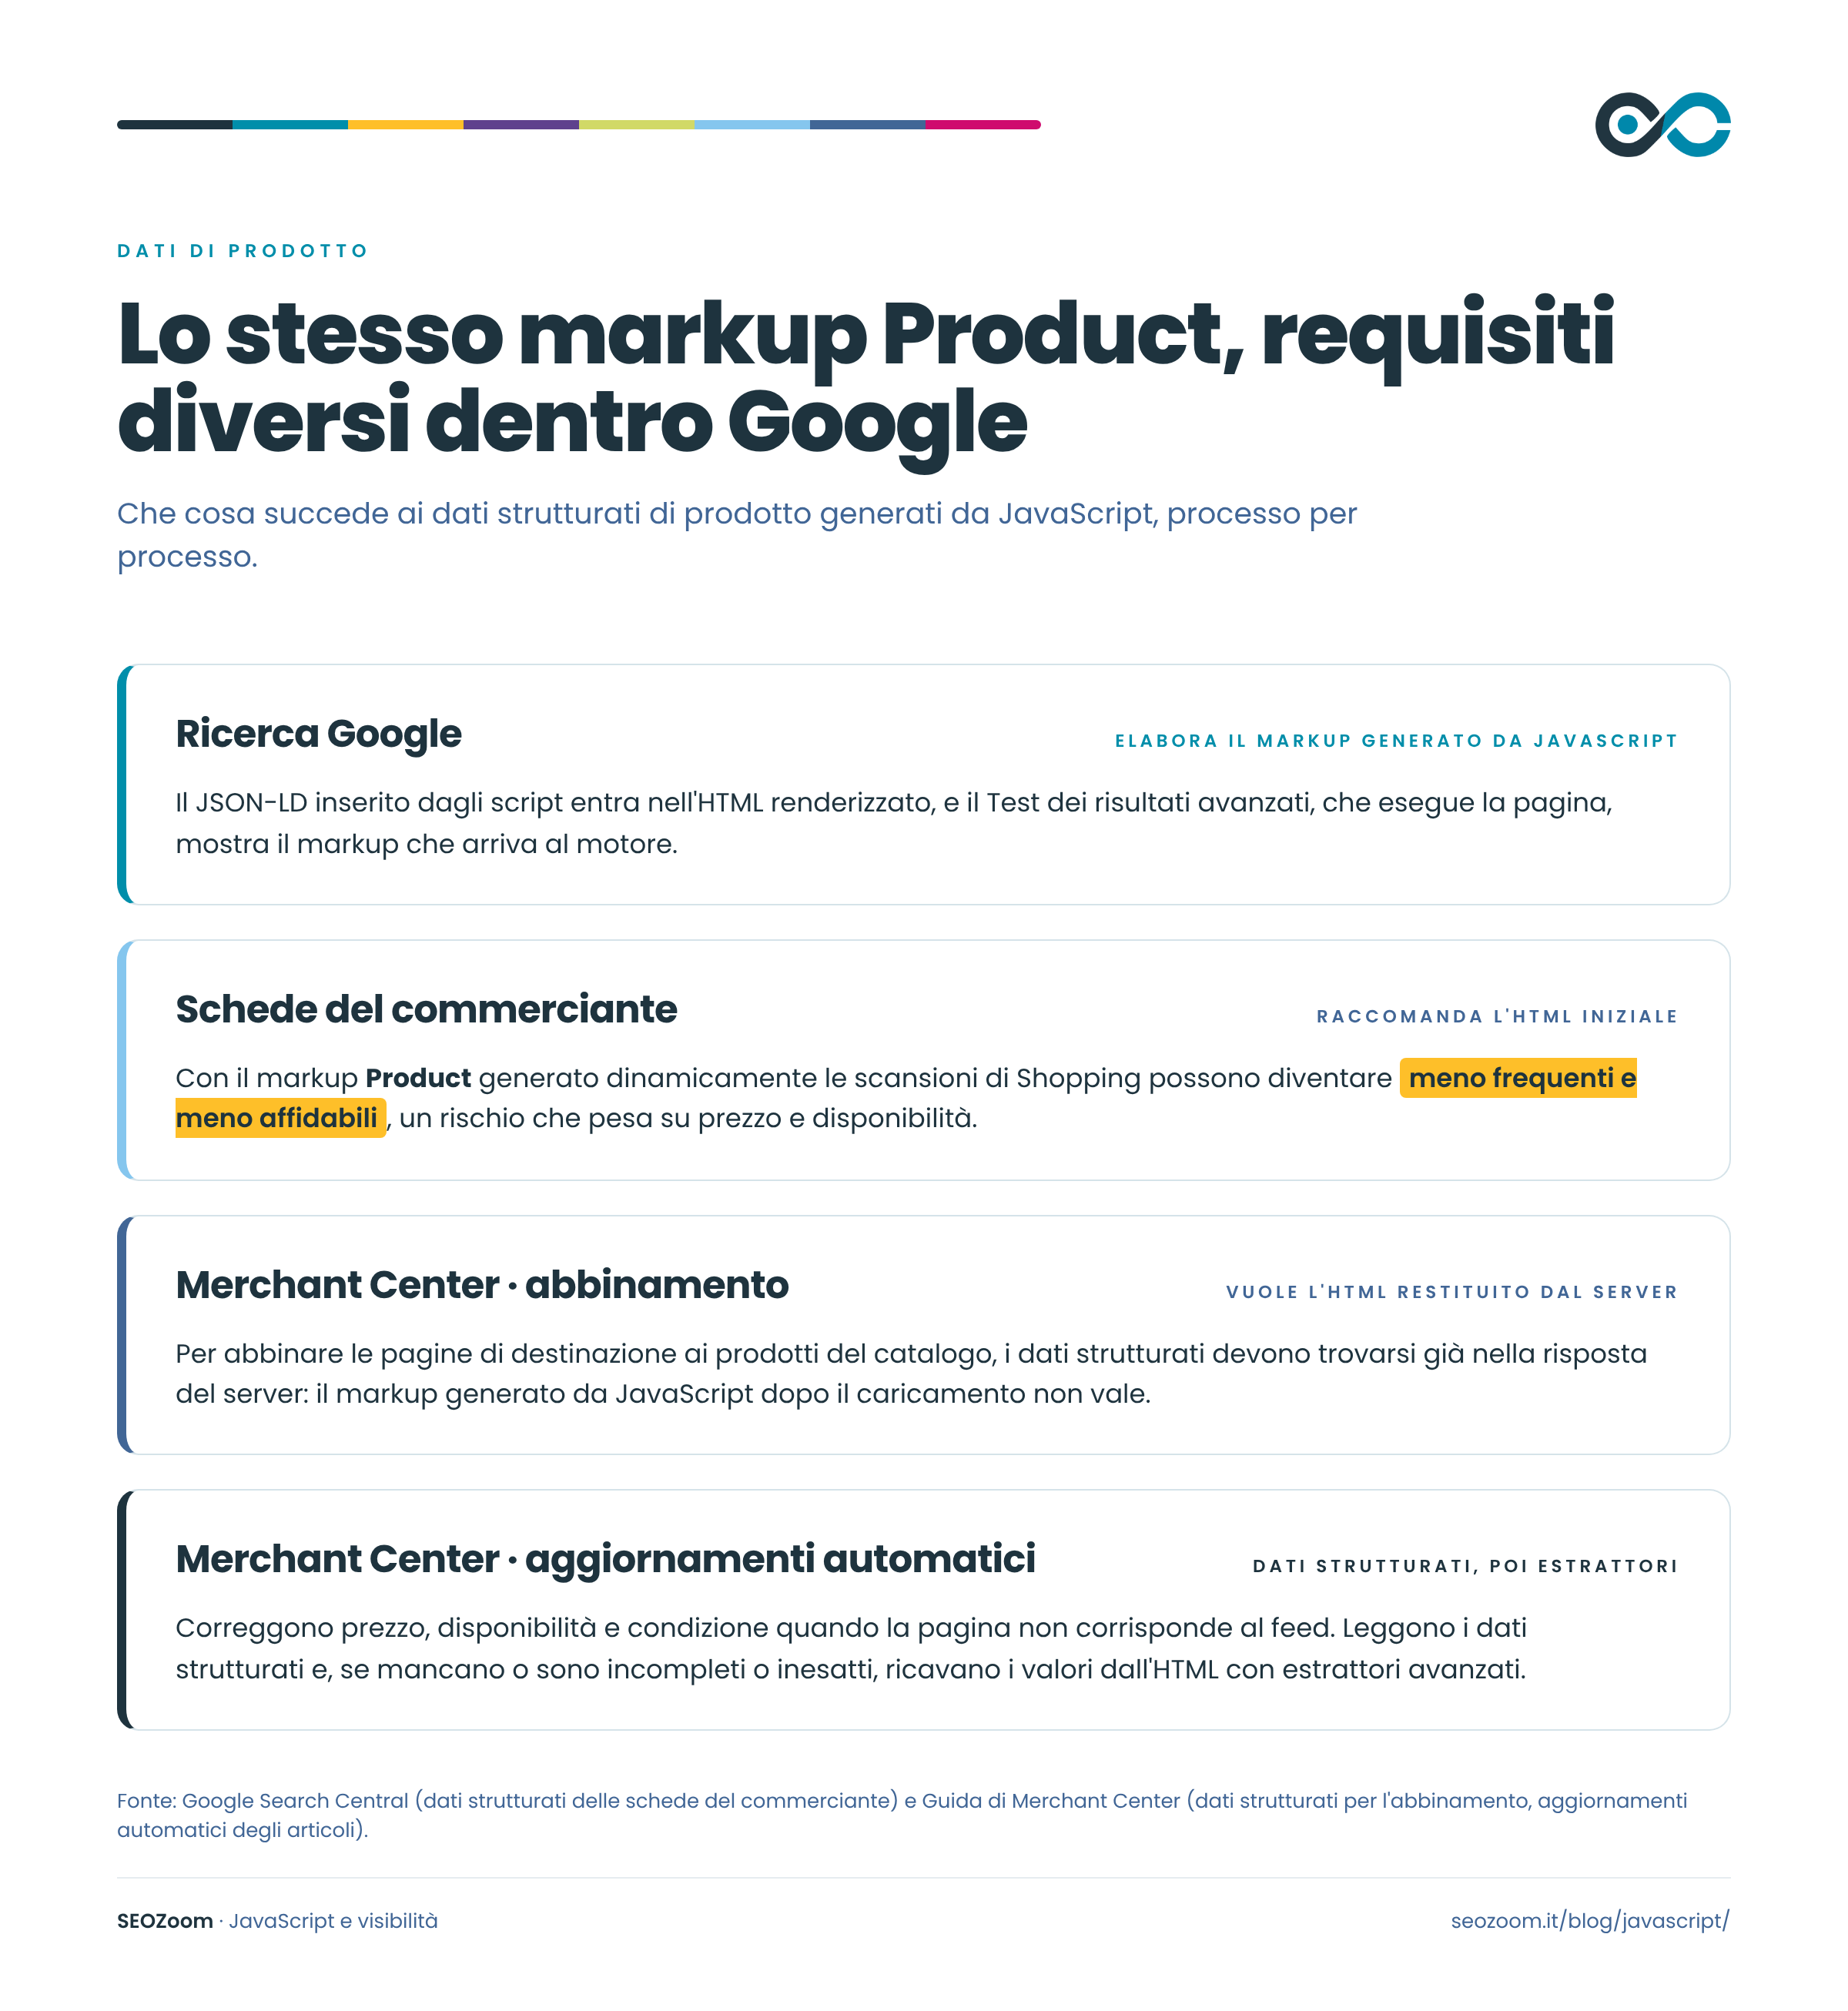
Anche i dati strutturati possono arrivare dagli script. La Ricerca Google elabora il JSON-LD generato da JavaScript, e il Test dei risultati avanzati, che esegue la pagina, ti mostra il markup che arriva al motore. Per i dati di prodotto, però, i sistemi commerciali di Google pongono condizioni in più su dove quel markup deve trovarsi.
Il codice di stato e le pagine che non esistono
Il codice di stato HTTP fa parte della risposta del server. JavaScript eseguito sul server può contribuire a stabilirlo, mentre quello eseguito nel browser parte quando la risposta è già arrivata e non può cambiarla. Una single-page application può così mostrare «Pagina non trovata» e rispondere 200 OK, perché il server ha consegnato correttamente l’applicazione, e soltanto dopo lo script ha scoperto che la risorsa richiesta non esiste.
Google può trattare questi casi come soft 404, pagine che dicono di non esistere con un codice che afferma il contrario. Dove l’architettura lo consente, il rimedio è che il server restituisca lo stato corretto. Nelle applicazioni che non possono farlo, la documentazione indica un reindirizzamento JavaScript verso un URL per cui il server risponde 404, oppure un noindex aggiunto dallo script alla vista di errore. Un prodotto temporaneamente esaurito è una pagina valida che risponde 200. I reindirizzamenti eseguiti da JavaScript, del resto, sono a loro volta una soluzione di riserva, per i casi in cui non puoi impostare un redirect lato server o un meta refresh.
Le risposte AI dentro e fuori da Google
AI Overview e AI Mode sono funzionalità della Ricerca Google e usano i suoi sistemi di base. Per comparire fra i collegamenti di supporto una pagina deve essere indicizzata e idonea a mostrare uno snippet, senza file speciali né markup dedicati, come chiarisce la guida di Google sulle funzionalità di AI. Quello che il WRS riesce a elaborare entra quindi nella rappresentazione della pagina che la Ricerca usa anche per queste risposte. L’idoneità è una condizione, e non garantisce che la pagina venga scelta come fonte. Dentro la Ricerca Google, per questo, AI Overview e AI Mode restano nel perimetro della SEO.
Fuori da Google il percorso cambia sistema per sistema. La ricerca di ChatGPT, per esempio, riscrive la domanda in una o più query mirate e le invia ai fornitori di ricerca con cui collabora, come spiega la documentazione di OpenAI; per gli account Enterprise ed Edu OpenAI nomina espressamente Bing. Per noi la base dell’AEO, il lavoro sulle risposte che gli assistenti costruiscono cercando sul web dal vivo, resta la presenza nella Ricerca. Un assistente che cerca dal vivo parte spesso dai motori tradizionali, Google in testa, il cui indice alimenta anche AI Overview e AI Mode. Una pagina assente dagli indici non compare fra i risultati da cui l’assistente sceglie le fonti.
Diverso è il caso della memoria dei modelli, cioè quello che un sistema ha appreso durante l’addestramento e usa anche senza fare una ricerca. È quello che chiamiamo GEO, il lavoro sull’identità e sulle associazioni con cui un modello riconosce un brand. Una modifica pubblicata oggi può essere recuperata dalla prossima ricerca dal vivo, mentre nella memoria di un modello entra soltanto con un nuovo addestramento, se ci entra. Memoria dei modelli e assistenti che non dipendono dalla Ricerca Google sono il terreno della SEO for AI, il lavoro che va oltre la SEO.
In tutti questi percorsi, a un certo punto, un programma deve leggere la pagina. Gli assistenti ne usano anche di propri, che raccolgono le pagine per la ricerca, per l’addestramento o le aprono su richiesta dell’utente, e quei programmi, a differenza di Google, non dichiarano che cosa fanno con il codice.
I programmi degli assistenti davanti al codice
Ogni operatore usa più programmi, con compiti distinti, e li dichiara con nomi propri nello user agent, la firma con cui ogni richiesta si presenta al server. Parlare genericamente di «bot delle AI» nasconde questa distinzione, che decide che cosa stai autorizzando o bloccando.
| Operatore | Risultati di ricerca | Addestramento dei modelli | Visite chieste dall’utente |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | Nessun programma dichiarato: PerplexityBot non serve all’addestramento | Perplexity-User |
Le impostazioni valgono programma per programma. Puoi consentire a OAI-SearchBot di raccogliere le pagine per la ricerca di ChatGPT, condizione per comparire fra i suoi risultati, e negare a GPTBot il loro uso per l’addestramento. I programmi che agiscono su richiesta dell’utente seguono regole a parte. OpenAI precisa che ChatGPT-User non scansiona il web in modo automatico e che, trattandosi di azioni avviate da una persona, le regole del robots.txt possono non applicarsi; Perplexity scrive che Perplexity-User in genere le ignora.
Sull’esecuzione di JavaScript le pagine di OpenAI, Anthropic e Perplexity non dicono nulla. Un’informazione che esiste soltanto dopo l’esecuzione degli script dipende quindi da una capacità che questi operatori non dichiarano, mentre un’informazione già presente nella risposta del server non ne dipende. Testi, collegamenti e dati di prodotto che vuoi far arrivare a questi programmi vanno nell’HTML che il server consegna.
Le altre condizioni di accesso restano. Il programma deve comunque poter richiedere la pagina, e un blocco nel robots.txt o una regola anti-bot della CDN lo fermano prima. Il server, poi, può restituire HTML diversi secondo dispositivo, lingua o sessione, oppure rispondere a un crawler con una pagina di verifica. I log del server mostrano che cosa riceve davvero ciascun programma, e conviene guardarli prima di trarre conclusioni.
Lo stesso dato di prodotto, requisiti diversi
Le differenze fra sistemi emergono bene sui dati strutturati dei prodotti, anche restando dentro Google. La Ricerca elabora il markup Product scritto nell’HTML iniziale e quello generato da JavaScript durante il rendering. Per le schede commerciali, però, la documentazione sui dati strutturati delle schede del commerciante raccomanda l’HTML iniziale e avverte che il markup generato dinamicamente può rendere le scansioni di Shopping meno frequenti e meno affidabili, un rischio che pesa sugli attributi che cambiano spesso, come prezzo e disponibilità.
Merchant Center, la piattaforma con cui i commercianti inviano a Google il proprio catalogo, va oltre. Per usare i dati strutturati nell’abbinamento fra i prodotti del catalogo e le pagine di destinazione chiede che il markup si trovi già nell’HTML restituito dal server, e precisa che non può essere generato da JavaScript dopo il caricamento. Gli aggiornamenti automatici degli articoli, che correggono prezzo, disponibilità e condizione quando la pagina non corrisponde al feed, leggono i dati strutturati e, se mancano o sono incompleti o inesatti, ricorrono a estrattori avanzati che ricavano i valori dall’HTML della pagina.
Un prezzo pubblicato in un solo modo può soddisfare la Ricerca e mancare i requisiti di Merchant Center. Un ecommerce che inietta il JSON-LD dei prodotti con un tag manager o con lo script di un’app vede il markup validato dal Test dei risultati avanzati, mentre Shopping può scansionarlo con minore frequenza e affidabilità e Merchant Center non lo può usare per abbinare le pagine ai prodotti.
Prezzi e disponibilità che viaggiano fuori dalla pagina
Le informazioni commerciali, del resto, non passano soltanto dalle pagine. Merchant Center riceve i dati dai feed e dalle integrazioni dei commercianti, e quei dati alimentano lo Shopping Graph, su cui Google costruisce anche l’esperienza di acquisto di AI Mode. Per ChatGPT, OpenAI scrive che i risultati del suo assistente allo shopping sono organici e basati sui siti di vendita pubblicamente disponibili, con le pagine dei prodotti consultate direttamente; prezzi e descrizioni possono arrivare anche dai metadati strutturati di fornitori propri e di terze parti, e per i negozi Shopify il catalogo è già integrato.
Pagina e catalogo hanno la stessa origine e arrivano a destinazione in tempi diversi. Il sito mostra il prezzo aggiornato dal gestionale mentre il feed conserva il valore dell’ultima sincronizzazione, e gli aggiornamenti automatici di Merchant Center servono a correggere questi disallineamenti.
Una risposta AI che riporta un prezzo diverso da quello del tuo sito ti dice che esiste una discordanza, non da quale fonte l’assistente abbia preso il valore. Può aver letto la pagina, un catalogo o una fonte intermedia, e la citazione dell’URL non certifica il percorso di ogni singolo dato. Per un errore nel feed intervieni sulla sincronizzazione del catalogo, dove il rendering della pagina non entra. E una pagina tecnicamente perfetta, d’altra parte, non obbliga un assistente a usare la versione più recente dei dati.
Agenti AI al lavoro sul sito
Un crawler recupera una pagina per leggerla. Un agente, invece, svolge un compito per qualcuno, e per farlo deve usare il sito: selezionare un filtro, scegliere una variante, compilare un modulo, prenotare, aggiungere un prodotto al carrello. L’agente di ChatGPT, per esempio, lavora con un browser visuale, un browser testuale, un terminale e l’accesso diretto ad API e connettori, chiede il permesso prima delle azioni con conseguenze, come un acquisto, e per l’accesso a un account chiede alla persona di intervenire, lasciandole il controllo del browser. La guida di Google sulle funzionalità di AI descrive agenti che nel browser possono ispezionare il DOM, interpretare l’albero di accessibilità e analizzare rendering visivi, cioè screenshot della pagina.
La dipendenza da JavaScript sta in un punto diverso secondo la strada che l’agente percorre. Un agente che lavora in un browser incontra le stesse condizioni degli altri lettori, cioè script da eseguire, richieste che devono andare a buon fine, sessioni, permessi e accessi, e in più deve interpretare l’interfaccia per capire dove agire. Un agente che passa da un’integrazione diretta può completare l’operazione senza attraversare la pagina, e allora dipende dalle funzioni e dai dati che l’integrazione mette a disposizione. Nella stessa guida compaiono protocolli come l’Universal Commerce Protocol, che consentiranno agli agenti della Ricerca di fare di più, e web.dev descrive WebMCP, uno standard proposto e ancora in sviluppo con cui un sito dichiara le proprie azioni agli agenti attraverso annotazioni HTML o JavaScript, con la conferma della persona per le operazioni delicate.
Comandi che un agente riconosce
Un agente si orienta su una rappresentazione della pagina che le macchine possono leggere. Può lavorare sul DOM, sull’albero di accessibilità, che per ogni elemento espone ruolo, nome e stato, oppure sugli screenshot interpretati da un modello di visione, una strada più lenta e costosa che le indicazioni di web.dev per i siti usati dagli agenti considerano adatta come riserva. Molti agenti combinano queste strade durante un compito.
Un <button> dichiara da solo il proprio ruolo, e un campo collegato a un <label> dice quale informazione si aspetta. Un <div> trasformato in pulsante da uno script risponde al mouse ed è muto nell’albero di accessibilità finché lo sviluppatore non gli assegna ruolo, nome e gestione della tastiera. Sono le stesse informazioni di cui ha bisogno uno screen reader, e il lavoro di accessibilità web che le rende disponibili alle persone le rende disponibili anche agli agenti.
Gli script aggiungono, dopo il caricamento, anche una parte degli ostacoli. Un livello trasparente sovrapposto alla pagina, come quello di certi popup o banner, copre gli elementi sottostanti, e gli agenti possono scartare i nodi coperti. Un pulsante «Aggiungi al carrello» che cambia posizione da una scheda all’altra confonde gli agenti che lavorano sugli screenshot. Il puntatore a mano che compare sopra un elemento cliccabile, con la proprietà CSS cursor: pointer, è per loro un segnale forte di azione possibile.
La conferma che un’azione è riuscita
Dopo aver premuto un pulsante, l’agente deve capire che cosa è successo. JavaScript aggiorna il contatore del carrello, segnala un errore nel modulo, cambia la disponibilità quando scegli una taglia. Un esito che compare soltanto come un colore o un’animazione non arriva a un sistema che lavora sull’albero di accessibilità, e all’agente manca l’informazione che gli serve per proseguire.
Le WCAG 2.1, le linee guida del W3C sull’accessibilità, dedicano a questo il criterio 4.1.3 sui messaggi di stato, secondo cui le comunicazioni sull’esito di un’azione devono essere riconoscibili dalle tecnologie assistive attraverso ruoli o proprietà, senza spostare il focus. Fra gli esempi del W3C ci sono il messaggio che aggiorna il numero di articoli nel carrello e quello che segnala gli errori di un modulo. Lo script che produce l’aggiornamento può esporlo anche così, con un ruolo come status o una regione aria-live.
Conta, alla fine, l’operazione completa. Un pulsante scritto correttamente può non completare l’acquisto perché una richiesta al server fallisce, un modulo accessibile può bloccarsi davanti a una sessione scaduta, un agente che lavora sugli screenshot può mancare un elemento che si sposta mentre tenta di selezionarlo. Sono problemi diversi, e ciascuno chiede un’osservazione sua.
Come scopri che cosa dipende dagli script
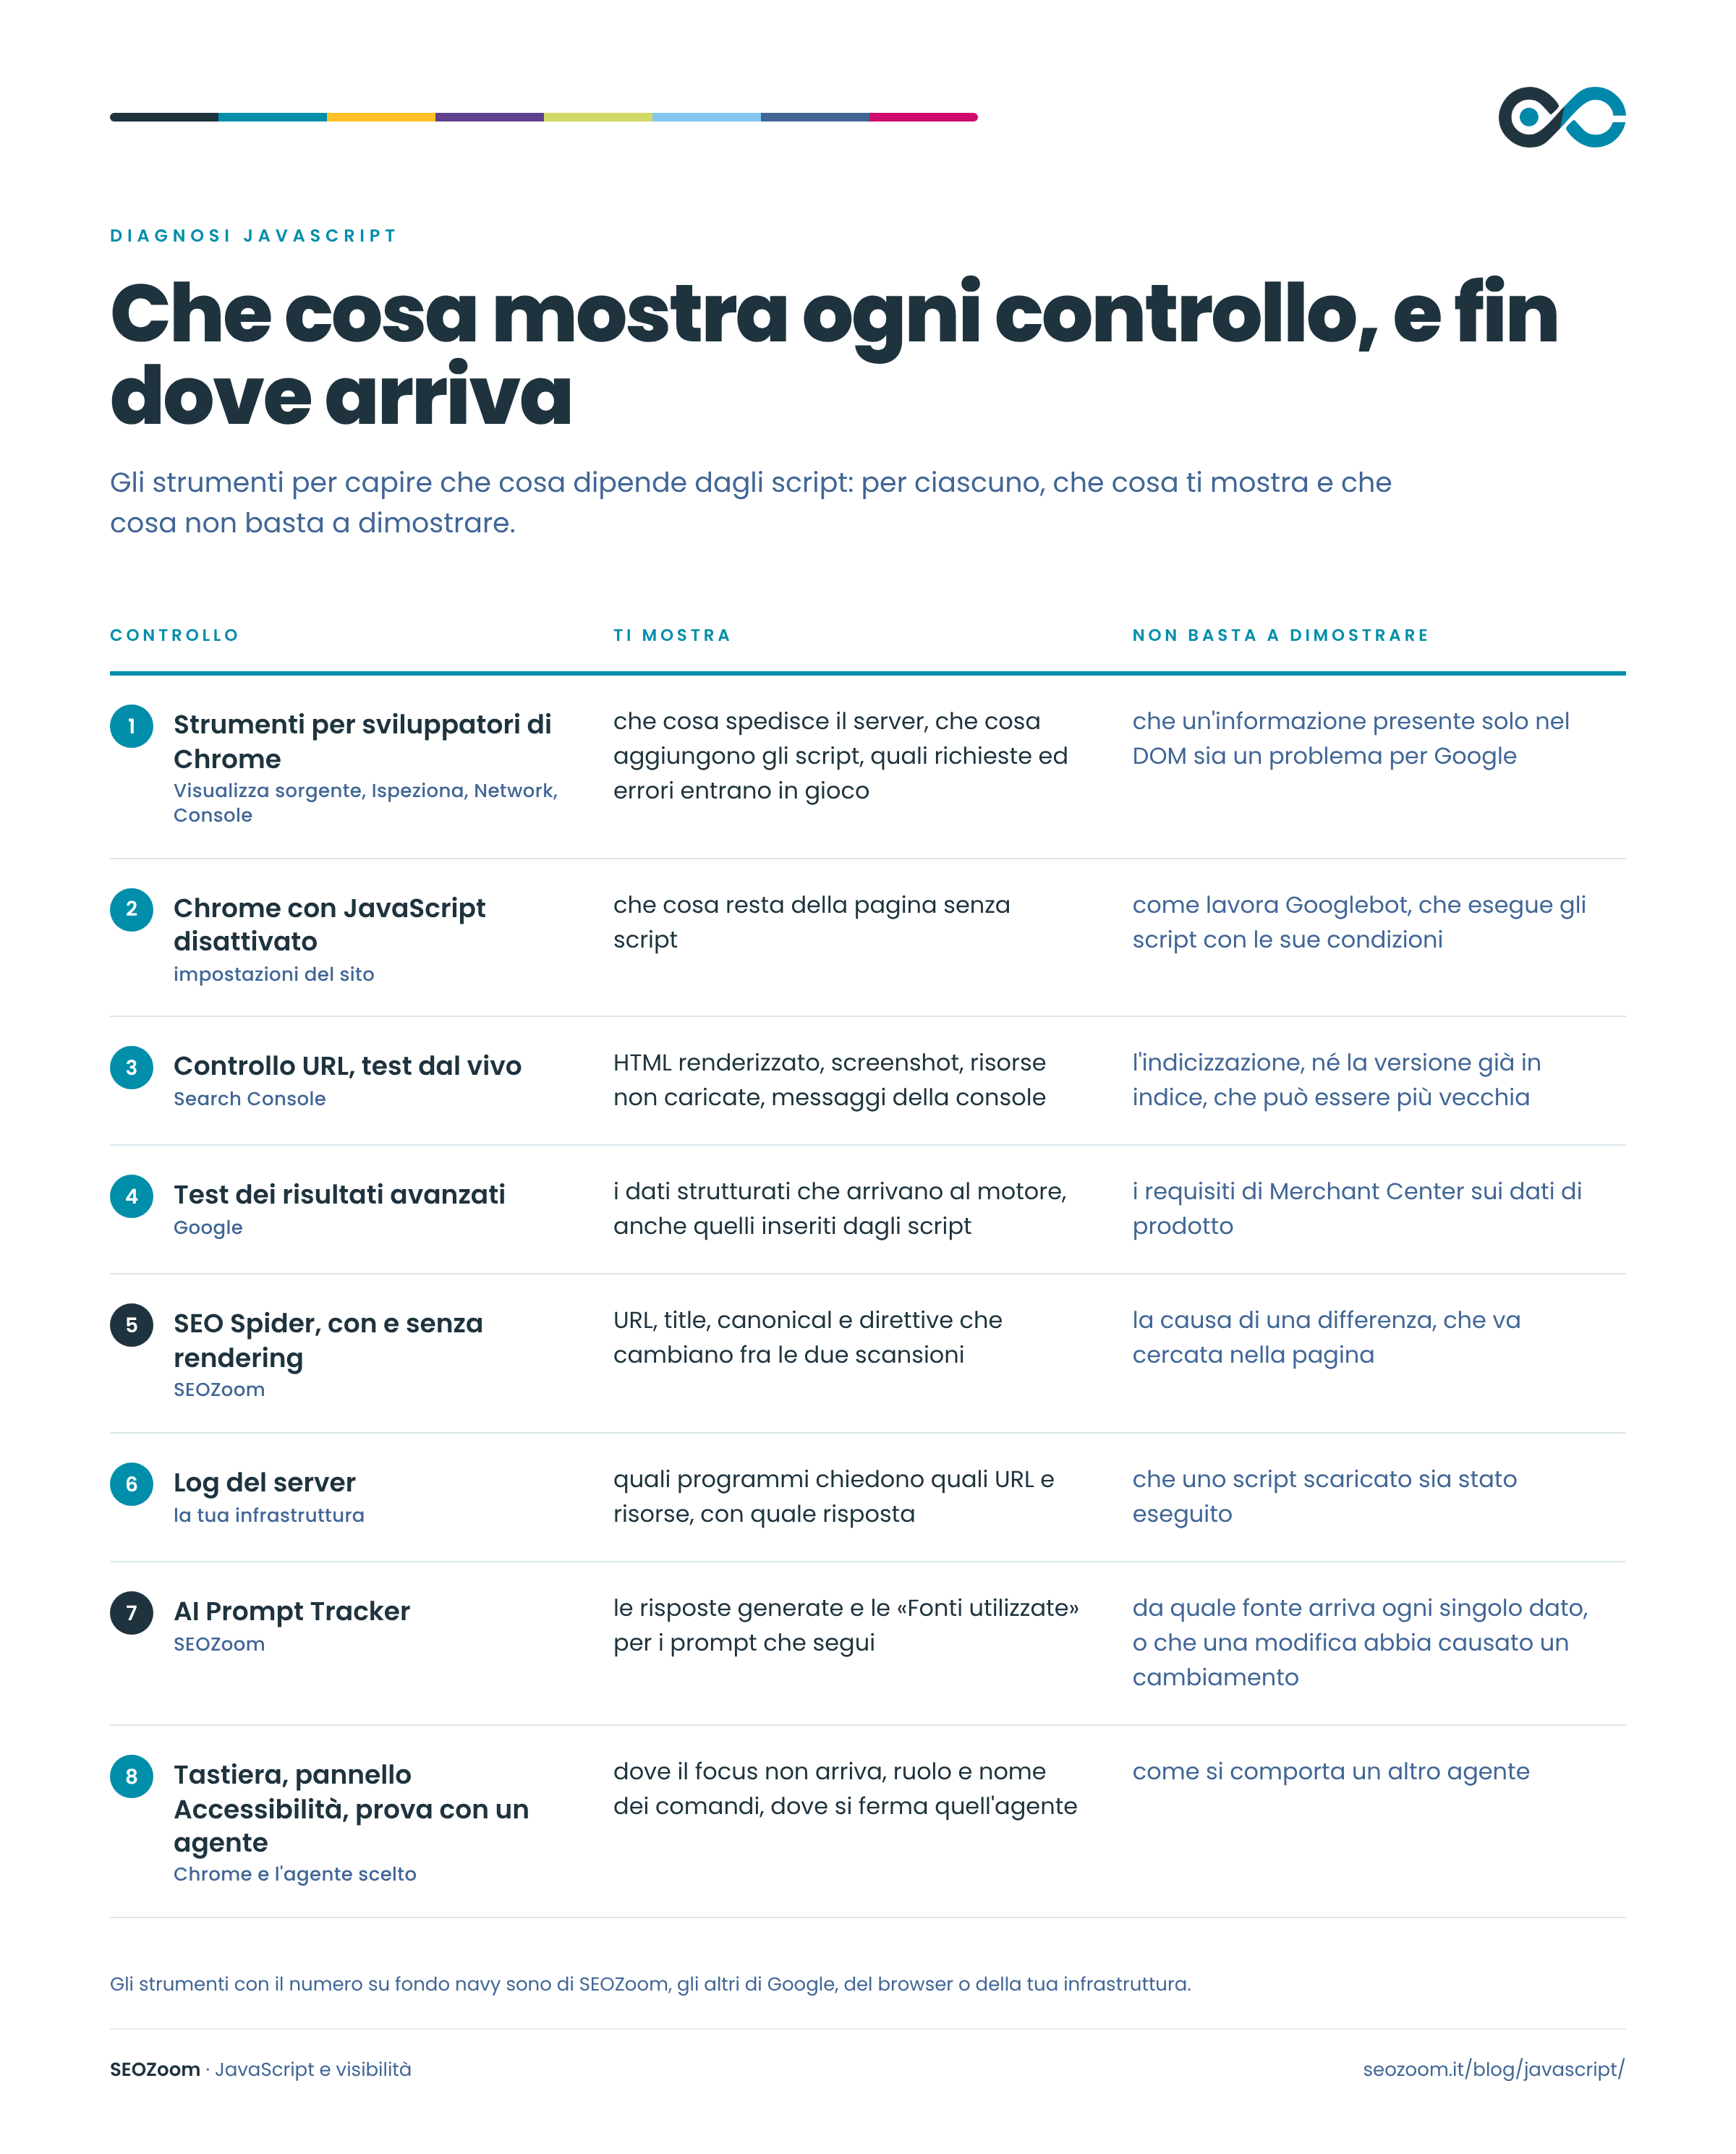
Il lavoro parte da un sintomo osservato, come una pagina che manca dall’indice, un testo che Google non mostra, un canonical ignorato, un’operazione che un agente non completa o un assistente che riporta un prezzo vecchio. JavaScript è una delle cause possibili, accanto alle altre che la SEO tecnica tiene sotto controllo, come un URL mai scoperto, una richiesta bloccata o una pagina che il motore ha recuperato e ha scelto di non indicizzare. I controlli servono a separare queste cause, e ciascuno risponde a una domanda precisa, senza dimostrare più di quanto misura.
Nel browser, con gli strumenti di Chrome
Il confronto fra sorgente e DOM rende di più su un elemento preciso. Copi una frase della descrizione che ti interessa, la cerchi nel sorgente e poi nel pannello Elements di Ispeziona, e trovarla soltanto nel secondo vuol dire che uno script l’ha aggiunta. Per un testo che compare dopo l’apertura di una sezione, la scheda Network ti mostra la richiesta partita con il clic, l’indirizzo a cui è andata e che cosa ha restituito, quindi se il testo arriva dal tuo server, da un’API interna o dal servizio di un fornitore. La scheda Console raccoglie gli errori JavaScript, e uno script che si interrompe a metà lascia vuoto tutto quello che avrebbe dovuto scrivere dopo.
Una risposta 403 su una risorsa, nella scheda Network, racconta un problema diverso da quello di uno script che non riesce a inserire una descrizione, perché lì la risorsa non è mai arrivata. E un contenuto già presente nell’HTML iniziale non dipende dall’esecuzione nel browser, qualunque cosa succeda dopo.
Disattivare JavaScript dalle impostazioni del sito, in Chrome, ti mostra che cosa resta della pagina senza script. È una prova utile per individuare la dipendenza, e non simula Googlebot, perché il server può rispondere in modo diverso a programmi diversi e il WRS esegue gli script, con le sue condizioni.
Per la parte che riguarda gli agenti il browser basta a cominciare. Percorri con il tasto Tab i passaggi che contano, dalla scelta della variante al carrello, e guarda dove il focus non arriva; in Ispeziona il pannello Accessibilità ti mostra il ruolo e il nome che il browser ha calcolato per ogni elemento, cioè quello che riceve un sistema che lavora sull’albero di accessibilità. Una prova con un agente specifico, infine, ti mostra dove si ferma quell’agente, e un altro agente può fermarsi altrove.
La versione di Google, in Search Console
Il Controllo URL di Search Console, con il test dal vivo, ti mostra l’HTML renderizzato, lo screenshot, le risorse della pagina che non è riuscito a caricare e i messaggi della console JavaScript. Un testo assente dal sorgente e presente nell’HTML renderizzato del test è arrivato a Google, almeno in quelle condizioni. Un testo che manca anche lì sposta l’analisi sugli script che dovrebbero produrlo, sulle richieste API, sulle risorse bloccate e sulle condizioni che il caricamento richiede.
La versione indicizzata può essere stata acquisita prima del test dal vivo, che descrive la pagina di adesso, e lo strumento le tiene distinte. Un rendering riuscito non decide da solo l’indicizzazione né il posizionamento, e per una pagina esclusa dall’indice il rapporto di Search Console indica il motivo, che può non avere niente a che fare con JavaScript.
Il Test dei risultati avanzati esegue la pagina e ti mostra i dati strutturati che arrivano al motore, compresi quelli inseriti dagli script. Per il markup dei prodotti il risultato va letto insieme ai requisiti di Merchant Center, che sull’HTML restituito dal server sono più severi. Nelle statistiche di scansione di Search Console, infine, trovi le richieste di Googlebot divise per tipo di file, JavaScript compreso, e per risposta del server, e vedi se i file degli script restituiscono errori o assorbono una quota insolita delle richieste.
Su tutto il sito, con due scansioni
Con il controllo manuale capisci come si comporta un modello di pagina. Su molti URL che condividono template e componenti ti serve una scansione dell’intero sito. In SEOZoom la lanci con il SEO Spider. Nella creazione di una nuova scansione c’è l’opzione «Abilita rendering Javascript», che la piattaforma accompagna con l’avviso «La scansione sarà più lenta ma è necessario per i siti web che utilizzano framework javascript come React o Angular», e il riepilogo della scansione indica «Rendering JS: Sì» o «No».
Lanci due scansioni dello stesso perimetro, una con l’opzione attiva e una senza, esporti le griglie in xlsx o csv dalle schede Title, Description, H1, H2, Canonical, Links, Directives e Hreflang e le confronti. Emergono gli URL trovati soltanto con il rendering, i title o i canonical che cambiano, le direttive che compaiono o spariscono dopo l’esecuzione degli script.
Una differenza fra le due scansioni ti dice dove guardare, e la causa va cercata nella pagina. Prima, però, le scansioni devono essere confrontabili, cioè fatte nello stesso momento, sullo stesso perimetro e fino in fondo. Ci è capitato con un grande ecommerce, dove due scansioni fermate dal limite di pagine prima di aver percorso tutto il sito avevano raccolto insiemi di URL diversi, e scansioni incomplete non dicevano se la differenza dipendesse dal rendering o da altro. Per un URL presente soltanto nella scansione con gli script eseguiti risali alla pagina che lo collega e guardi come nasce il collegamento. Un link inserito da uno script indica una dipendenza da JavaScript per quel percorso di navigazione, e il motore può comunque eseguire lo script o conoscere l’indirizzo da una sitemap. Un title o un canonical che cambia fra le due scansioni indica a sua volta una pagina da aprire, per capire se a cambiare il valore è uno script o la risposta del server, diversa fra una scansione e l’altra.
Log del server e risposte degli assistenti
I log del server registrano le richieste che arrivano alla tua infrastruttura, e sono il posto in cui vedi passare i programmi degli assistenti, con gli URL che chiedono, le risposte che ricevono e i file JavaScript o le API che eventualmente scaricano. Lo user agent si può falsificare, quindi per verificare una richiesta conviene confrontarla con gli intervalli IP che OpenAI e Perplexity pubblicano per i loro programmi. E lo scaricamento di uno script, nei log, non dimostra che il programma l’abbia eseguito.
Sul lato degli assistenti osservi le risposte. In SEOZoom l’AI Prompt Tracker segue i prompt che scegli e, per ciascun motore, ti mostra il testo della risposta generata e le «Fonti utilizzate». Ti dice quali informazioni compaiono e quali pagine l’assistente cita sulle domande che contano per il tuo brand. La risposta non ricostruisce il percorso tecnico di ogni singolo dato. Un prezzo superato è il punto da cui parte l’indagine, che passa dalla pagina, dal feed e dai log, e non sempre porta a una fonte sola. E una risposta che cambia dopo una modifica al sito non dimostra da sola che la modifica ne sia la causa, perché le risposte variano anche per conto loro.
Quale intervento scegliere dopo la diagnosi
La diagnosi può trovare un collegamento creato soltanto dopo un clic, una richiesta API che fallisce durante il rendering, un’applicazione che affida al browser la composizione di tutte le pagine pubbliche, un feed che non segue il sito. Le conseguenze si somigliano, perché in ogni caso un’informazione non arriva dove era attesa, e gli interventi riguardano componenti e responsabilità diverse. Un problema circoscritto a un widget non giustifica il cambio di architettura; una correzione puntuale non basta quando tutte le pagine di una sezione nascono nel browser.
Correggere un singolo componente
Con il contenuto principale già nella risposta del server e la navigazione raggiungibile, l’intervento riguarda il singolo componente, e JavaScript continua a gestire le funzioni interattive. Un elemento che fa da collegamento soltanto con onclick diventa un vero <a href>, e lo script gestisce il clic come prima. Una sezione che chiede il proprio contenuto soltanto al clic può riceverlo già nel documento e limitarsi a mostrarlo, quando quelle informazioni devono essere recuperabili senza interazione. Su un widget di terze parti il margine dipende dal fornitore, perché alcuni offrono un’integrazione lato server o un’API con cui portare i contenuti nella pagina, altri no, e scegliere il fornitore vuol dire decidere anche quali programmi potranno leggere quei contenuti.
Un contenuto aggiunto automaticamente al caricamento, che compare nell’HTML renderizzato del Controllo URL, non ha un problema con Google. Portarlo nell’HTML iniziale è una scelta che riguarda gli altri lettori, cioè i programmi che non dichiarano di eseguire JavaScript e i processi, come Merchant Center, che vogliono i dati nella risposta del server.
Per le istruzioni ai motori intervieni nel punto in cui nascono, tenendo il canonical in un solo posto, che sia il template o il tag manager, e togliendo il noindex dal codice che genera la risposta di una pagina destinata all’indice. Per gli agenti, infine, ruoli, etichette e messaggi di stato sono lavoro sull’interfaccia, perché il rendering lato server consegna l’HTML prima, e i controlli sono quelli che il componente dichiara.
Un nuovo modo di comporre le pagine
Un’applicazione che restituisce un HTML quasi vuoto per molte pagine pubbliche è un caso diverso. Con un recupero dei contenuti che dipende in modo sistematico dall’esecuzione nel browser, e una diagnosi che ha mostrato problemi concreti, come testi assenti dal rendering, URL non scoperti o dati di prodotto che non soddisfano Merchant Center, l’intervento riguarda il modo in cui nascono le pagine.
| Strategia | Dove e quando nasce l’HTML | Che cosa contiene la risposta del server |
|---|---|---|
| Client-Side Rendering | Nel browser, durante l’esecuzione degli script | Il guscio dell’applicazione, i riferimenti agli script e le parti che lo sviluppatore ha scelto di includere |
| Server-Side Rendering | Sul server, a ogni richiesta | Il documento composto per quella richiesta, con i contenuti che l’applicazione inserisce sul server |
| Static Site Generation | Sul server, al momento della pubblicazione | Il documento preparato in anticipo, uguale fino alla generazione successiva |
| Prerendering | Al momento della pubblicazione, eseguendo l’applicazione | Un’istantanea HTML dello stato iniziale dell’applicazione |
| Rendering dinamico | Su un servizio che esegue l’applicazione per i crawler | Ai crawler una versione prerenderizzata, alle persone l’applicazione costruita nel browser |
Con il rendering lato server il contenuto che l’applicazione decide di inserire è già nella risposta, e le funzioni interattive si attivano dopo, nel browser. La generazione statica si adatta ai contenuti pubblicabili come documenti già composti, e chiede di rigenerare le pagine quando le informazioni cambiano; dove il framework la supporta, la rigenerazione incrementale aggiorna le singole pagine secondo regole di scadenza o di invalidazione. Le architetture combinano spesso queste strategie, e la scelta dipende dalla natura dei contenuti, da quanto spesso cambiano e da quali funzioni devono restare nel browser. La guida di web.dev sul rendering nel web mette a confronto queste strategie con i costi che ciascuna sposta fra server e browser.
Una pagina composta sul server non contiene per forza tutto quello che il visitatore vede. Disponibilità e varianti recuperate da uno script dopo il caricamento continuano a dipendere dall’esecuzione, anche dentro un’architettura SSR, e la diagnosi le tratta come tali.
Il rendering dinamico è documentato da Google come soluzione alternativa, non consigliata nel lungo periodo per la complessità e le risorse che richiede. In genere non è cloaking finché crawler e persone ricevono contenuti simili, mentre servire contenuti del tutto diversi lo è; il suo costo vero sta nel tenere allineate due versioni dello stesso sito. Un cambio di rendering, poi, spesso porta con sé un cambio di framework, e indirizzi, redirect e canonical devono restare coerenti con le risorse pubblicate, perché un HTML completo non compensa URL cambiati senza criterio.
Il prezzo di portare le informazioni sul server
Spostare un’informazione dal browser al server cambia anche il modo in cui si aggiorna. Un prezzo scritto nell’HTML diventa recuperabile senza eseguire JavaScript; se però quel documento resta in cache più a lungo di quanto durano i prezzi, il sito distribuisce un valore superato a tutti i programmi che leggono la risposta. Insieme al rendering decidi durata della cache, regole di invalidazione e origine del dato, altrimenti la correzione di una dipendenza introduce un errore nelle informazioni pubblicate.
Sul server, poi, il rendering chiede risorse per comporre le pagine, e la cache ne riduce il peso. Il browser, dal canto suo, deve comunque eseguire JavaScript per rendere interattiva l’applicazione. È l’idratazione (hydration), il passaggio in cui gli script collegano stato e comportamento all’HTML arrivato dal server. L’idratazione presuppone che il DOM prodotto sul server sia quello che l’applicazione si aspetta, e quando i due non coincidono compaiono errori o modifiche inattese al momento dell’attivazione. Alcune architetture riducono il JavaScript eseguito nel browser attivandolo soltanto nei componenti che ne hanno bisogno, con l’idratazione parziale o progressiva e le cosiddette isole; web.dev avverte che l’idratazione parziale è difficile da realizzare.
Prima di cambiare rendering, quindi, metti in fila le dipendenze che vuoi togliere e le responsabilità che ti prendi in cambio, dalla cache al carico del server all’allineamento fra quello che il server compone e quello che il browser attiva.
Il contenuto di base e le funzioni in più
Il miglioramento progressivo (progressive enhancement) è il principio che tiene disponibile per il maggior numero possibile di persone una base di contenuti e funzioni essenziali, e affida a JavaScript il resto, dove il browser può eseguirlo. Il menu contiene già i collegamenti e lo script lo apre; il modulo dichiara campi ed etichette e lo script aggiunge i controlli immediati; il catalogo rende raggiungibili le pagine successive con URL stabili e offre in più lo scorrimento infinito.
Non tutte le applicazioni possono funzionare senza JavaScript, e nessuno lo chiede a un configuratore, a una dashboard o a un’area riservata. Le informazioni pubbliche che devono essere trovate attraverso la ricerca, però, hanno esigenze diverse dalle funzioni riservate alle persone che stanno usando l’applicazione, e la pagina di un configuratore può comunque esporre le caratteristiche del prodotto anche fuori dal componente interattivo.
Allo sviluppatore, a diagnosi fatta, porti decisioni precise. Quali informazioni devono trovarsi nella risposta del server, dai testi ai collegamenti, dalle direttive ai dati di prodotto per Merchant Center. Quali URL devono essere raggiungibili senza un clic. Quali controlli devono esporre ruolo, nome, stato e messaggi di esito per gli agenti. E, quando il problema è un prezzo o una disponibilità che non coincidono fra sito e sistemi esterni, la sincronizzazione del catalogo, da sistemare prima di toccare il rendering.
La dipendenza da JavaScript cambia insieme al sito. Un plugin nuovo, l’aggiornamento di un componente o del framework, un servizio esterno aggiunto alla pagina possono spostare il momento in cui un’informazione diventa disponibile. Dopo ogni rilascio che tocca la produzione dei contenuti o la navigazione ripeti il controllo che ti aveva mostrato il problema, sulle pagine coinvolte: l’HTML renderizzato nel Controllo URL per un testo, il percorso che lo rende raggiungibile per un collegamento, il feed e i dati in Merchant Center per le informazioni commerciali, l’operazione completa per un agente.


 Recensioni verificate su Trustpilot
