Che cos’è AEO? Guida alla visibilità che nasce dentro le risposte AI
L'AEO porta brand e contenuti dentro le risposte che l'AI costruisce sul momento: che cos'è, dove il lavoro cede e come misurare i risultati
Una parte di chi potrebbe visitare il tuo sito oggi non ci passa più. Scrive la domanda a ChatGPT oppure su Google e trova una risposta già composta, che confronta le opzioni e consiglia due o tre nomi. Non esisteva un minuto prima, perché il modello non la ricordava o non la conosceva.
Se pensi solo al traffico, quella visita è persa. Ma in realtà la tua pagina potrebbe esserci entrata lo stesso: il motore l’ha recuperata, ne ha preso una frase, l’ha cucita insieme a materiale di altri e l’ha consegnata senza inserire il tuo nome da nessuna parte. L’informazione ha lavorato per te, ma l’attribuzione è finita altrove.
Comparire in una sintesi e ricavarne qualcosa oggi sono due risultati diversi: posizione e clic dicono come va una pagina, e tacciono su che cosa ne resta lì dentro e a chi viene attribuito. L’AEO lavora su quella distanza e alza le probabilità che il tuo contenuto arrivi al lettore con il tuo nome accanto. È il pilastro della SEO for AI che agisce nel momento in cui il testo viene costruito, e ha una caratteristica che la rende preziosa: quello che succede in quella fase dipende da materiale su cui puoi intervenire oggi.
Cos’è l’Answer Engine Optimization
L’Answer Engine Optimization, in sigla AEO, è il lavoro con cui porti i tuoi contenuti e il tuo brand dentro le risposte che i motori AI costruiscono consultando il web in tempo reale, e con cui li tieni riconoscibili una volta che ci sono arrivati.
La premessa è che nel funzionamento della visibilità AI fonte, menzione e raccomandazione sono tre forme di presenza con lavori diversi dietro. Una tua pagina può essere recuperata e usata come fonte mentre il marchio resta invisibile nel testo che la persona legge. Il tuo nome può essere pronunciato grazie a un comparatore, mentre il sito rimane chiuso. E puoi comparire in ogni confronto del settore restando sempre a un passo da chi l’assistente consiglia.
Prendi un produttore di materassi. Qualcuno chiede a un assistente quale materasso vada bene per chi dorme sul fianco e soffre di mal di schiena. La risposta chiarisce la differenza tra le densità, consiglia alcuni brand, e tra le fonti in fondo c’è la guida sulle posizioni del sonno pubblicata proprio da quel produttore. Il suo contenuto ha costruito la spiegazione, i nomi consigliati sono altri. Quell’azienda è servita come fonte e il suo nome è rimasto fuori: è la situazione più frequente, e la meno visibile.
Il testo finale è stato composto con materiale di provenienze diverse. La parte sulle densità viene dalle pagine aperte in quel momento, e portarci dentro le tue è lavoro di AEO, che dipende da quello che pubblichi adesso. I nomi consigliati possono uscire dalle stesse pagine, un comparatore o una recensione aperti insieme alle altre, oppure da quello che il modello aveva già imparato sul mercato dei materassi molto prima della domanda.
La relazione tra SEO for AI, GEO e AEO
Il modello ti conosce in due modi che rispondono a leve opposte, e il lavoro sull’AI generativa si divide di conseguenza. Da una parte c’è l’immagine che ha sedimentato durante l’addestramento leggendo il web fino a una certa data, quella che restituisce a occhi chiusi quando gli chiedi chi sei: sa che esisti, in quale categoria ti mette, accanto a quali concorrenti ti nomina, e cambia soltanto quando il modello viene riaddestrato. È il terreno della GEO, e i suoi tempi si misurano in mesi.
Dall’altra c’è quello che raccoglie sul momento, aprendo pagine che un istante prima gli erano ignote per rispondere a una domanda che la sua memoria non copre: lì intervieni con quello che pubblichi adesso, e l’effetto si vede in giorni. È il campo dell’AEO.
Per capire perché le distinguiamo ti basta una prova che fai in cinque minuti. Chiedi a un modello di descrivere il tuo brand a navigazione spenta, poi rifai la stessa domanda lasciandogli la ricerca attiva, e metti i due esiti uno accanto all’altro. Se ti descrive male in entrambi i casi, sbagliando settore o attribuendoti un’offerta che hai chiuso, il deposito è vecchio e nessun articolo pubblicato oggi lo riscrive in tempo utile. Se invece ti riconosce a memoria e poi, appena cerca, costruisce il testo su un comparatore e su qualche concorrente mentre le tue pagine restano fuori, il guasto è nel presente ed è materia di AEO. Chi salta questa verifica pubblica per un anno mentre il modello continua a collocarlo nel settore sbagliato, e se ne accorge quando il calendario editoriale è già esaurito.
Entrambe convivono dentro la SEO for AI, che è la cornice in cui le teniamo insieme, e nessuno di questi lavori sostituisce la SEO – conviene dirlo prima che qualcuno provi a venderti il contrario. Le funzionalità AI di Google poggiano sull’indice della Search, con le stesse condizioni di sempre; i sistemi che cercano dal vivo interrogano indici esistenti, spesso proprio quelli di Google, per recuperare le informazioni da sintetizzare. Una pagina che manca dall’indice resta fuori da qualsiasi bacino di candidati, e su quel vuoto non c’è niente da ottimizzare. Il ranking conserva quindi tutto il suo valore e cambia funzione: da obiettivo diventa condizione d’accesso, e un dominio solido entra nel bacino con più documenti e più spesso.
La sigla e i suoi usi fuori dall’Italia
L’acronimo AEO è più vecchio dei motori che descrive oggi, perché è in uso dai tempi dei featured snippet e degli assistenti vocali, quando “motore di risposta” indicava la posizione zero di Google e ottimizzare voleva dire conquistare quel box. Molte fonti anglosassoni la usano ancora oggi come etichetta ombrello per qualsiasi intervento rivolto all’AI, quindi un articolo inglese intitolato AEO può parlare di reputazione del brand, di dati strutturati o di tecniche di prompting, argomenti che per noi appartengono a lavori distinti e con tempi diversi. Quando leggi un pezzo straniero conviene guardare che cosa tratta davvero, prima di portarne le conclusioni dentro il tuo piano.
Google, da parte sua, tiene una posizione netta e riconduce AEO e GEO a un’unica pratica, la SEO, perché i sistemi che generano risposte dentro la Search usano lo stesso indice e gli stessi segnali. Sul piano tecnico l’argomento regge; sul piano operativo lascia scoperta la domanda che serve a chi lavora, cioè se il problema di oggi stia nelle pagine che il motore apre oppure in quello che il modello ha già imparato, perché le due risposte portano a interventi opposti. Accanto continuano a circolare AIO, LLMO, AISO e le altre sigle della visibilità AI, che si sovrappongono spesso e coincidono raramente: quando ne incontri una, la domanda utile riguarda su quale strato agisce.
La finestra in cui l’AEO ha effetto
Un modello AI non va a cercare ogni volta. Se la domanda rientra in quello che ha assimilato durante l’addestramento, compone il testo da lì, senza aprire un solo documento esterno; in quel caso le tue pagine non entrano nella conversazione, e riscriverle non sposta quella risposta di una virgola. Il recupero dal vivo si attiva quando la richiesta riguarda fatti recenti, quando chiede una verifica, quando tocca temi che il modello copre male, oppure quando è l’utente a chiederlo esplicitamente. ChatGPT dichiara entrambe le modalità, automatica e su richiesta; le funzioni AI di Google lavorano sull’indice della Search espandendo la domanda in sottotemi; Perplexity si presenta come sistema che cerca sul web a ogni interrogazione. È dentro quella finestra che l’AEO ha effetto.
Prima di cercare, il sistema smonta il prompt che la persona ha scritto, che solitamente è lungo, colloquiale, spesso impreciso. Lo normalizza, lo scompone in token, elimina formule di cortesia e parole senza peso informativo, e da quello che resta ricava le entità in gioco e l’intento, convertendolo in un punto di uno spazio matematico. “Come pulire il materasso eliminando le macchie” diventa un oggetto (il materasso), una condizione problematica (le macchie) e un tipo di azione e operazione richiesta (la pulizia). Da quel punto parte la ricerca. Un contenuto collocato in una zona diversa o ambiguo perché parla di tutto un po’, esce di scena prima ancora che il recupero cominci, e nessun intervento sulla pagina lo recupera se il tema non è stato scelto con chiarezza.
Sull’intento così ricostruito si apre il query fan-out, la sventagliata di ricerche parallele con cui il motore copre le sfumature del bisogno senza affidarsi a un’interrogazione sola, in modo da ottenere un sottoinsieme diversificato di pagine che raccontino aspetti complementari al posto di una fila di documenti che ripetono la stessa cosa.
Quelle ricerche non hanno tutte la medesima forma, ed è un dettaglio che cambia il modo di fare keyword research. Chi valuta un gestionale per uno studio dentistico ne attiva alcune che somigliano alle chiavi di sempre – “gestionale odontoiatrico prezzi”, “software gestionale studio dentistico” – e altre che restano domande intere, come “quanto dura la migrazione dei dati da un gestionale a un altro” o “quali gestionali per dentisti gestiscono la fatturazione elettronica”. Quasi tutte si collocano a metà del percorso: nessuna chiave di testa, poca coda lunga estrema, perché pescare dal centro dà al sistema più probabilità di trovare documenti che coprono sfumature multiple e gli risparmia il costo di tornare sul web a ogni nuova domanda della conversazione.
Una pagina costruita sul termine generico compete su un ramo solo; una che affronta prezzo, limiti, confronti e casi d’uso ricompare in liste diverse, e ogni diramazione è un’occasione di entrare che gli altri non danno. Con il nostro AI Prompt Research parti da una domanda formulata come la scriverebbe un cliente e leggi gli ambiti che attiva – informational, valutazione e comparazione, fiducia e affidabilità, transactional, follow up – con le sotto-famiglie di ricerche che compongono ciascuno e le indicazioni sul taglio da dare al contenuto. È la differenza fra progettare una pagina sapendo in quante direzioni verrà interrogata e scriverla sperando di indovinare.
Se copri anche le domande che arrivano dopo – l’obiezione sul prezzo, il confronto con l’alternativa, la procedura di migrazione, la sorte dei dati in caso di ripensamento – il sistema continua a servirsi di quello che ha già senza tornare a cercare. Finché la conversazione resta sul terreno che hai coperto i concorrenti non vengono nemmeno cercati, ma basta che la persona apra un aspetto nuovo perché il motore torni sul web.
Conta anche quello che succede dopo la risposta. I sistemi osservano se una sintesi ha chiuso la ricerca o ha spinto l’utente a chiedere altro, e un contenuto che permette al modello di rispondere in modo esaustivo, risparmiandogli follow-up di chiarimento, si consolida come scelta sicura per quel gruppo di domande. Funziona come l’apprendimento per rinforzo dal feedback umano con cui questi modelli vengono allineati: una risposta che soddisfa vale più di una formalmente corretta, e la fonte che l’ha resa possibile guadagna terreno sulle interrogazioni successive.
Perché le tue pagine possono essere scartate
Le ricerche parallele restituiscono decine di documenti e il sistema ne apre pochi. La scelta avviene su titoli ed estratti, quindi su quello che della pagina si vede senza averla ancora scaricata: la qualità del contenuto, in quel momento, è invisibile. Title e description escono da questo passaggio con un altro peso: smettono di essere una rifinitura sul tasso di clic e tornano a essere il materiale su cui una macchina decide se aprirti. “Gestionale per studio dentistico: costi, integrazioni e tempi di migrazione” offre appigli su cui le ricerche possono cadere; “Il nostro software per dentisti” resta muto.
C’è un dettaglio della fase che non deve sfuggirti: Google riscrive gli snippet adattandoli alla query, prendendo dal contenuto i passaggi che rispondono a quella domanda specifica, quindi lo stesso indirizzo può presentarsi al motore con anteprime diverse – una sui prezzi, una sui tempi di migrazione, una sulle integrazioni. Il sistema arriva alla pagina sapendo già a quali domande risponde, e per saperlo gli è bastata la SERP.
Dove si può perdere il tuo contenuto
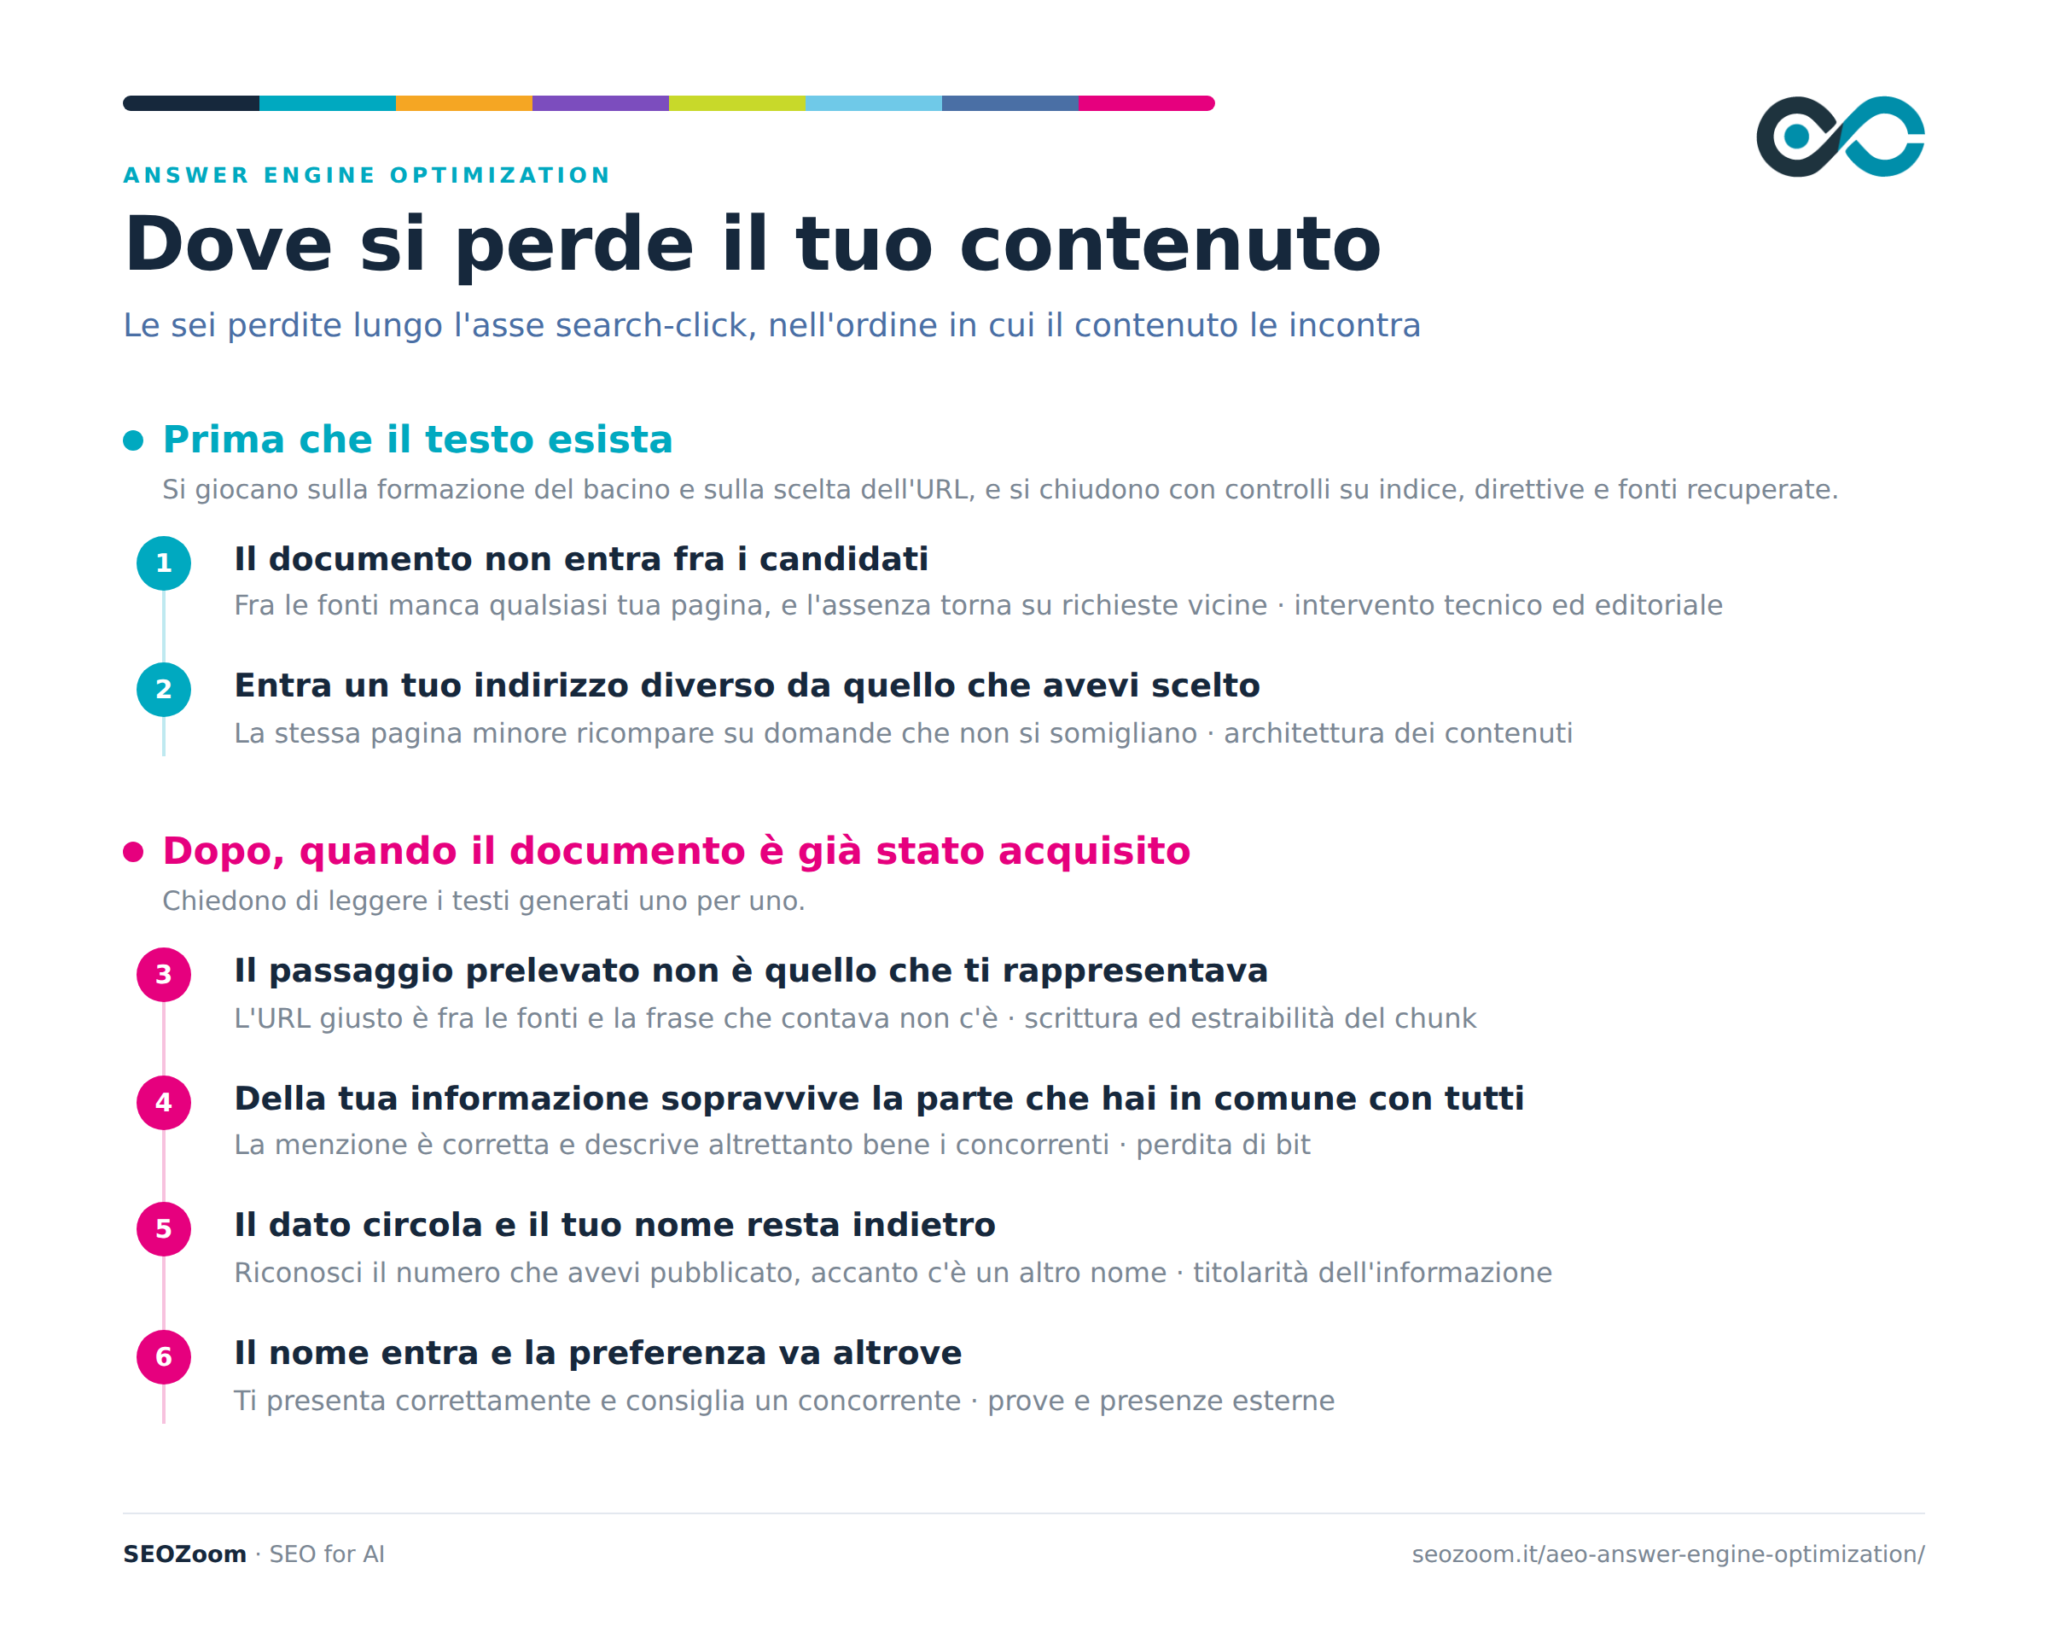
Quando il tuo nome manca da una risposta vedi solo il sintomo finale, sotto il quale agiscono cause che chiedono interventi opposti.
Riscrivere le pagine è la reazione più comune e in buona metà dei casi fa parte della soluzione, ma è anche l’intervento che costa di più, in ore e in calendario: puntarlo prima di sapere quale anello ha ceduto significa spendere il budget più alto sul bersaglio più incerto, e scoprirlo mesi dopo, quando il piano editoriale è già consumato.
Prima della diagnosi serve una prova che regga. Il testo generato cambia da una sessione all’altra, quindi una singola schermata non dimostra niente: la stessa domanda va ripetuta a distanza di giorni, sullo stesso motore, salvando ogni volta il testo prodotto, l’elenco delle fonti e la pagina che ti riguarda. Quando la tua assenza si ripete a ogni rilevazione hai un caso su cui lavorare; quando capita una volta sola hai un’oscillazione, e mettere mano alle pagine per quella significa correggere un rumore.
Le perdite possibili sono sei: due si giocano prima che il testo esista, sulla formazione del bacino e sulla scelta dell’URL. Le altre quattro dopo, quando il documento è già stato acquisito e comincia a essere lavorato.
- Il documento non entra fra i candidati. Guardi le fonti di una risposta sul tuo mercato e non trovi una tua pagina, poi provi richieste vicine e la scena si ripete. A quel punto il problema smette di riguardare come hai scritto quel contenuto e riguarda se il motore lo abbia mai avuto sotto gli occhi. Le cause si dividono fra un piano tecnico, che si verifica in poco tempo e ha esiti binari, e un piano editoriale, che chiede di confrontare quello che hai pubblicato con le domande che il ventaglio genera davvero.
- Indicizzazione e idoneità allo snippet. Le ricerche AI sul web usano spesso l’indice della Search, quindi valgono le condizioni base delle linee guida di Google: il documento deve essere indicizzato e poter comparire con uno snippet. Una canonical incoerente, una pagina che i collegamenti interni raggiungono a fatica, un’esclusione dall’indice dimenticata in un file di configurazione sono controlli che fai già per la SEO, e qui pesano allo stesso modo.
- I permessi che hai dato senza ricordartene. Le direttive con cui in passato hai limitato gli snippet valgono anche per le risposte generate, e quasi sempre in azienda nessuno ricorda di averle messe. nosnippet, data-nosnippet e max-snippet tolgono il testo dal materiale che le funzioni AI possono usare, esattamente come lo sottraggono ai risultati: quello applicato tre anni fa a una scheda tecnica, per tenere i prezzi lontani dalla SERP, oggi taglia fuori quella pagina da un canale che allora non esisteva, e nessuno se ne accorge finché non va a cercarlo nel codice.
- Registrazione e paywall. Il contenuto protetto va letto con una distinzione, perché Google lo scansiona e lo indicizza quando il markup dichiara che l’accesso è limitato, e quindi resta idoneo alle sue funzioni AI, mentre i crawler dei laboratori si fermano davanti al muro e compongono il testo con quello che raccolgono altrove. Se il tuo materiale migliore vive lì dentro, su una parte dei motori il tuo mercato viene raccontato senza di lui, e la cosa non dipende da come è scritto.
- Il codice che gli agenti non eseguono. Google elabora il JavaScript anche quando genera le sue risposte AI, perché passa dallo stesso sistema di rendering della Search, mentre gli agenti degli altri motori in larga parte lo ignorano, e per loro quello che si carica via script semplicemente sparisce. La scheda prodotto che mostra prezzo e disponibilità soltanto dopo un clic su “vedi dettagli” è leggibile per Google e muta per gli altri, e il rimedio consiste nel portare quel contenuto nel sorgente e non in un’interazione.
- L’opt-out che non fa quello che credi. Google-Extended è il controllo che riguarda l’addestramento dei modelli e vive separato dalla scansione per la Search. Quindi governa una cosa sola, se i tuoi contenuti possano addestrare i modelli Gemini, mentre a raccogliere le pagine per l’indice della Search resta Googlebot con la sua normale scansione. Bloccare Google-Extended ti esclude dall’addestramento e ti lascia esattamente dov’eri nelle risposte generate dentro la Search, che da quell’indice attingono. Finisci per autoescluderti da un canale credendo di proteggere i contenuti da un altro. Sul file llms.txt, invece, la situazione è chiara: Google ha dichiarato che non lo supporta e che resterà così, e le rilevazioni sui siti che lo pubblicano mostrano bot che in larghissima parte non lo richiedono nemmeno.
- Il vuoto editoriale.Una pagina può essere impeccabile sul piano tecnico, indicizzata, veloce e ben collegata, e restare lontana dalle ricerche che il bisogno genera. Il fornitore di gestionali con una guida perfetta su che cosa sia un software gestionale sparisce dalle fonti di chi chiede quanto costa il passaggio da un sistema all’altro o quali soluzioni si integrano con il registratore di cassa: quella pagina funziona, semplicemente risponde a un’altra domanda. Nessun report tecnico segnala un argomento che non hai coperto: lo vedi affiancando l’elenco delle ricerche che una richiesta attiva a quello dei tuoi indirizzi.
- Entra un URL diverso da quello che avevi scelto. Il dominio compare fra le fonti, quindi l’accesso funziona e la parte tecnica ha fatto il suo lavoro. Poi apri l’elenco e trovi un articolo di tre anni fa, una scheda di prodotto, un approfondimento laterale che offriva una frase più diretta, mentre la guida su cui avevi investito sei mesi non c’è. Il lavoro editoriale è stato fatto, e il motore è entrato da un’altra porta.
- Come lo riconosci. La stessa pagina minore continua a comparire su richieste che non si somigliano fra loro, e quella ricorrenza dice più di qualsiasi ipotesi: se un documento secondario risponde a domande diverse mentre il principale non compare mai, la scelta del motore è sistematica e non casuale.
- Da dove viene. Due documenti con funzioni troppo vicine lasciano al sistema una decisione che spettava a te, e title, heading, collegamenti interni e specificità dei passaggi raccontano quale dei due risponde meglio a quella richiesta. Quel racconto può contraddire la mappa editoriale che avevi in testa, perché la guida generale, scritta per coprire tutto, perde contro il post che affronta un sotto-problema con una frase più netta e più verificabile.
- Che cosa non fare. La tentazione, quando te ne accorgi, è pubblicare un documento ancora più completo dei precedenti, e la distribuzione peggiora invece di aggiustarsi, perché sullo stesso ruolo si presenta un contendente in più e la scelta diventa ancora meno prevedibile.
- Dove si interviene. Riparti da quello che hai già online: la pagina principale deve contenere ciò che le altre trattano di sfuggita, i collegamenti interni devono dichiarare la relazione fra i documenti invece di limitarsi a esistere, e le secondarie hanno il compito di stringere il proprio perimetro fino a uscire dalla competizione. Due pagine convivono bene quando hanno funzioni davvero distinte, la guida che spiega il problema e la scheda che vende la soluzione, e allora il lavoro consiste nel rendere esplicita quella distinzione; a funzione identica, tenerle entrambe significa continuare a delegare la scelta a una macchina.
- Il passaggio prelevato non è quello che ti rappresentava. L’indirizzo giusto compare fra le fonti e nel testo generato manca la frase che contava, quella su cui avevi costruito la differenza rispetto a chiunque altro. Qui il guasto è nella scrittura, ed è il caso in cui riscrivere serve davvero, a patto di sapere che cosa riscrivere.
- Che cosa viene preso. Il sistema applica il chunking, divide il documento in blocchi e carica nel RAG quelli pertinenti alla domanda, quindi nella composizione non entra mai la pagina intera ma un frammento, che arriva staccato dal paragrafo che lo precedeva e viene valutato per conto proprio.
- Che cosa lo fa scartare. L’estraibilità è la tenuta di quel blocco quando qualcuno lo legge da solo. Un passaggio che dice “in questo caso i tempi si allungano di parecchio” viaggia orfano del soggetto, del caso a cui allude e di qualsiasi misura, quindi costa fatica da usare e viene sostituito da uno più autonomo, magari di un dominio più debole del tuo.
- Quando è il codice a decidere. Se la prosa è vaga e i dati strutturati dichiarano un valore preciso, prevale quello dichiarato: alla descrizione che promette un prodotto “accessibile” il modello preferisce lo “price”: “499.00” dello schema, perché i parser trattano il markup valido come indice di verità della pagina. Nessuna marcatura, da sola, ti procura un posto nelle risposte; toglie però al modello il margine per indovinare proprio dove indovinare fa più danno, sui prezzi, sulle date e sulle specifiche tecniche.
- Della tua informazione sopravvive la parte che hai in comune con tutti. Scrivi “il supporto risponde entro due ore nei giorni feriali e entro sei nel fine settimana”, e nel testo generato leggi “assistenza rapida”; scrivi “il pannello gestisce fino a cinquantamila prodotti senza degrado delle prestazioni”, e diventa “adatto anche a cataloghi grandi”. La soglia evapora, il confronto perde il termine di paragone, e quello che avevi misurato torna al lettore come una qualità che chiunque può dichiarare. La chiamiamo perdita di bit, e la pagina che l’ha subita compare regolarmente fra le fonti: è per questo che il danno passa inosservato mentre ogni indicatore di presenza segna verde.
- Come lo riconosci. La menzione è corretta, ti mette in buona luce e descrive altrettanto bene i tuoi concorrenti principali. Se togli il tuo nome da quella frase e la leggi come se parlasse di un’altra azienda del settore, e continua a funzionare, hai la conferma che il differenziale non è arrivato in fondo.
- Il linguaggio che si presta alla compressione. Periodi lunghi, incisi e subordinate allontanano la quantità dal soggetto a cui appartiene, e quando il modello accorcia è proprio quel legame a saltare per primo, perché è il pezzo che costa di più da ricostruire. Non serve scrivere corto, serve tenere vicini soggetto, misura e condizione dentro lo stesso passaggio.
- Gli appigli che mancano. Il dato esiste ma viaggia orfano della sua unità, la condizione che lo rende vero vive tre paragrafi più avanti, la tabella è stata sostituita da un periodo discorsivo per ragioni di impaginazione. In tutti questi casi il valore c’è e il legame no, e nella compressione sopravvive solo quello che era già legato.
- Il caso a monte. A volte il differenziale manca dall’origine, perché “soluzione su misura”, “qualità superiore” e “assistenza dedicata” offrono alla compressione soltanto aria: non c’è niente da perdere, perché non c’era niente da misurare, e il lavoro torna indietro di un passo, alla raccolta dei dati che nessun concorrente può dichiarare al posto tuo.
- Il dato circola e il tuo nome resta indietro. Un’informazione che chiunque potrebbe aver scritto viaggia benissimo da sola, e nel viaggio si stacca da chi l’ha prodotta: la trovi nel testo generato, riconosci il numero che avevi pubblicato, e accanto c’è il nome di qualcun altro oppure non c’è nessun nome. È l’esito più frequente per chi produce contenuti buoni, ed è anche quello che i report di presenza registrano come un successo.
- Che cosa tiene attaccata la firma. Un dato raccolto da te su un campione dichiarato, una soglia che hai misurato con un metodo, un indicatore che hai battezzato restano legati a chi li ha prodotti, perché il rapporto fra il numero e la sua origine fa parte dell’informazione e toglierlo la rende meno utile a chi la usa. Un dato anonimo, invece, è già pronto per essere ripetuto senza di te.
- Come si scrive. Studi, metriche e metodi proprietari chiedono una denominazione identica su tutte le pagine, una data e un autore esplicito, e il nome del brand deve stare accanto al dato che lo giustifica, a distanza di lettura e non di sezione, perché il prelievo porta via quello che trova insieme. Un numero scritto in forma impersonale, con l’autore relegato nel box biografico in fondo all’articolo, produce un passaggio facile da estrarre e altrettanto facile da separare da chi lo ha prodotto.
- Quello che un modello non produce da sé. Il dettaglio di un’esperienza diretta, il rumore anomalo che un componente fa dopo mesi di lavoro, il comportamento di un materiale quando cambia la stagione, l’opinione motivata che spiega perché una scelta è giusta in una circostanza e sbagliata in un’altra: sono la parte che una sintesi fatica a rendere anonima, perché senza chi l’ha vissuta quell’informazione perde la ragione per cui vale.
- Il valore di EEAT nell’AI. Esperienza, competenza, autorevolezza e affidabilità sono un paradigma di Google, nato per orientare i suoi valutatori e i suoi sistemi, e dentro ChatGPT o Perplexity non esiste nulla di dichiarato che gli somigli. Funziona lo stesso, però, perché un sistema generativo che deve attribuire un’informazione ha il medesimo problema del motore: nessuno possiede un sensore per la verità, e allora ci si affida a segnali misurabili che stanno al posto di quello che non si può osservare. Un’identità dichiarata, un autore riconoscibile, un dato verificabile e una presenza coerente sul tema sono i sostituti matematici della fiducia, e in un ambiente dove ogni affermazione inventata costa credibilità diventano la garanzia che permette alla macchina di citarti con il tuo nome invece di lasciare il dato anonimo.
- Il limite da dichiarare. Nessuna di queste regole garantisce la citazione del brand, e vanno prese per quello che sono, cioè misure prudenziali che alzano le probabilità. Restano comunque preferibili all’alternativa, che consiste nel pubblicare informazioni già anonime in partenza e sperare che qualcuno le attribuisca.
- Il nome entra e la preferenza va altrove. Alle domande di selezione, quelle in cui l’utente chiede quale prodotto scegliere per una situazione precisa, il sistema produce una lista ristretta e spiega perché ogni nome è finito lì dentro. Quella giustificazione pesa più della presenza, perché dichiara il criterio con cui sei stato scelto, e da lì si capisce se la posizione che occupi è tua o te l’ha prestata qualcun altro.
- Su quale attributo sei stato giudicato. Entri per il prezzo, per la specializzazione verticale, per l’assistenza, oppure come alternativa al limite di un concorrente. Essere consigliato perché “costa meno di X” è una posizione che dipende dalle scelte di X e svanisce appena l’altro corregge il listino, mentre tu sei rimasto fermo. Due brand con lo stesso numero di raccomandazioni possono quindi avere prospettive opposte, e la differenza sta nelle motivazioni, non nei tassi.
- Perché il tuo sito conta poco. Consigliare un brand chiede criteri, confronti e riscontri che il suo stesso dominio fatica a produrre, e quando la domanda precede un acquisto il sistema pesa recensioni, condizioni e comparatori più di qualunque spiegazione tu abbia pubblicato, perché si fida meno di ciò che un’azienda dice di sé. È il terreno dei money prompt, dove si decide la preferenza e dove il lavoro editoriale, da solo, non basta.
- Le prove che nascono fuori da quel che dici di te. Una parte di prove devono necessariamente essere ricavate da quello che di te dicono gli altri, perché l’informazione può coprire anche difetti, esperienze reali o problemi ricorrenti. Il motore apre gli ambienti in cui quel materiale si forma: Reddit e i forum verticali, i gruppi di categoria, le schede su Trustpilot e sui marketplace, i commenti sotto i video di chi prova i prodotti. Un assistente che deve giudicare un prodotto aggrega quello che una persona avrebbe ricavato leggendo una lunga fila di recensioni, e il commento negativo che prima si perdeva in fondo alla seconda pagina di un portale oggi entra in una descrizione che il tuo cliente legge per intero. Una critica che clienti diversi ripetono diventa una caratteristica sintetica del brand, e a quel punto riscrivere serve a poco: un’informazione vecchia si aggiorna e un errore fattuale si contesta, mentre un problema reale di assistenza resta credibile finché il servizio continua a produrlo.
- Le promesse che cedono.“Completo”, “innovativo” e “semplice” si scrivono in un secondo e diventano inservibili dentro una raccomandazione, mentre utenti inclusi, tempi di attivazione, integrazioni disponibili, soglie e condizioni legano il brand a una necessità precisa. Una prova vale poi soltanto dentro il perimetro in cui è stata raccolta, perché un risultato ottenuto su un grande ecommerce descrive male una piccola attività: restringere la promessa rafforza la credibilità, mentre una dichiarazione larga sembra più potente finché non incontra un confronto serio.
- L’obsolescenza delle informazioni. C’è anche il caso in cui la risposta racconta un’azienda che non esiste più, con un servizio che hai chiuso o un prezzo vecchio di due listini. Il modello riporta quello che trova e sceglie l’informazione sbagliata perché è la più diffusa nelle pagine che apre, quindi il rimedio somiglia a un’inondazione più che a una correzione: allineare nello stesso periodo le fonti che controlli, pubblicare aggiornamenti e comunicati datati, portare la versione corretta negli ambienti in cui il settore discute. Se l’errore sopravvive anche alla prova a navigazione spenta si è depositato nella memoria, e i tempi di ottimizzazione si allungano.
- Le fonti che tornano sempre. Dentro il bacino delle risposte di un settore ricorrono quasi sempre gli stessi domini, e ripetendo le rilevazioni sulle stesse domande vedi quali tornano: sono i documenti che il sistema seleziona più spesso per comporre una risposta su quel mercato, e la domanda che pesa è se il tuo sito stia fra loro. Il bersaglio della digital PR si sposta di conseguenza, perché un elenco di domini ordinati per metriche di autorità descrive un’autorevolezza generale, mentre le fonti che ricorrono nelle risposte registrano una selezione già avvenuta, su quel bisogno e in quell’ambiente. La seconda lista si costruisce, non si intuisce, e raramente coincide con i concorrenti commerciali: testate di settore, domini accademici e istituzionali, magazine specializzati, community, canali video, blog di consulenti indipendenti. Il peso poi non è uniforme, perché una citazione su una testata giornalistica o su un dominio universitario sposta la collocazione del brand più di molte uscite raccolte in ambienti minori.
- Il movimento contrario. Citare e collegare fonti autorevoli dentro i tuoi contenuti ti accosta a loro nello stesso spazio in cui il modello ti sta collocando, mentre un sito che per prudenza evita di nominare chiunque altro rimane isolato in una zona che nessuno attraversa. È la parte di digital PR che fai sulle tue pagine, per la quale non serve alcuna trattativa.
- Video e podcast. Un episodio è già materiale recuperabile, perché gli spider dei laboratori trascrivono il parlato con i modelli di riconoscimento vocale e lo indicizzano come farebbero con un articolo, quindi quello che dici davanti a un microfono viene tokenizzato come se lo avessi scritto. A mancare, quasi sempre, è l’appiglio: senza una trascrizione pubblicata come pagina vera, con titoli, struttura e dati leggibili, quel contenuto resta un file in una piattaforma e non diventa un documento che il motore può citare.
- Dove guardare per capire chi risponde al posto tuo. Nell’AI Visibility di SEOZoom la vista Top fonti del settore ordina i domini che compaiono più spesso nelle risposte ai tuoi prompt per numero di prompt, posizione media e co-citazioni con il tuo brand, e raramente coincidono con i concorrenti commerciali: sono testate di settore, community, comparatori, canali video. La vista Fonti dove non compari elenca invece quelli che alimentano le stesse risposte senza di te, ed è da lì che parte il lavoro di presenza esterna.
Le prime due perdite si chiudono con controlli su indice, direttive e fonti recuperate, senza bisogno di aprire quello che l’AI ha scritto. Le altre quattro chiedono di leggere i testi generati uno per uno, e percorrerle in quest’ordine evita di rimettere mano a un anello che ha già retto.
Gli equivoci più diffusi sull’ottimizzazione per gli Answer Engine
Intorno all’AEO si è formato in fretta un cumulo di prescrizioni che non discendono da come i sistemi funzionano, e circolano con la sicurezza delle regole. Alcune sono resti di un’epoca precedente della ricerca, altre nascono da una lettura frettolosa del modo in cui i modelli trattano i testi, altre ancora le vende qualcuno. Hanno in comune il fatto di costare qualcosa di preciso: tempo speso su interventi che non spostano niente, contenuti peggiori di quelli che avevi già, mesi di lavoro su un livello sbagliato.
Ridurre l’AEO ai featured snippet è il malinteso che sopravvive da più tempo, e si riconosce da come scrive chi ci crede ancora: paragrafi costruiti per essere copiati di peso, definizioni in quaranta parole piazzate in cima alla pagina, domande in grassetto seguite dalla risposta secca. Aveva senso quando la posta in gioco era il riquadro in cima alla SERP, che prendeva un passaggio da un documento solo. Un sistema generativo non copia: raccoglie da più fonti, tiene quello che può usare senza rischiare e monta un testo che nessuna di quelle fonti aveva scritto. Non conta più quale tua frase potrebbe essere estratta, ma che cosa il tuo contenuto aggiunge a una sintesi che verrà composta comunque, anche senza di te.
Anche l’idea che basti sistemare la pagina giusta regge poco alla prova. Per stimare quanto può fidarsi di una fonte su un tema il sistema guarda il contesto in cui quel documento sta, quindi quante altre tue pagine affrontano lo stesso argomento da angoli diversi, se i collegamenti interni dichiarano di che cosa parla la pagina che raggiungono o sono soltanto collegamenti, se la terminologia resta stabile o cambia a ogni articolo. Un intervento chirurgico su un singolo contenuto migliora quella pagina e lascia il dominio dov’era, ed è la ragione per cui una pagina ottima pubblicata su un sito che tratta il tema di sfuggita continua a non comparire da nessuna parte.
La sovraottimizzazione del testo è il malinteso più recente e il più dannoso. Poiché i sistemi analizzano i documenti a blocchi, si è diffusa l’abitudine di spezzare tutto in paragrafi brevissimi, domande seriali e risposte di due righe, come se la frammentazione rendesse il contenuto più digeribile per una macchina. L’esito è innaturale e controproducente, perché un testo smontato in micro-unità perde la profondità che lo rendeva utile a chi legge e toglie al modello proprio il contesto che gli serve per capire che cosa sta comprimendo. L’autonomia di cui hai bisogno riguarda il significato e non la lunghezza, e si ottiene in modo chirurgico: rimetti il soggetto dove lo davi per sottinteso, sciogli i rimandi al capoverso precedente, porta la misura accanto all’affermazione che la regge, e il resto della prosa continua a respirare come prima.
Riscrivere i contenuti quando il guasto sta nella memoria del modello è invece l’errore che brucia più tempo, perché consuma mesi di calendario editoriale prima di manifestarsi. Succede a chi non ha fatto la prova a navigazione spenta e attribuisce alle proprie pagine una responsabilità che non hanno: se il sistema ti colloca nel settore sbagliato anche senza cercare, il calendario editoriale non è lo strumento giusto, e l’intervento si sposta sull’identità del brand, con i tempi lunghi che le appartengono. La verifica costa cinque minuti e va fatta prima di aprire il documento del piano editoriale, non dopo.
Inseguire requisiti tecnici inventati per l’occasione alimenta un piccolo mercato di soluzioni che promettono un canale privilegiato. Markup dedicati all’AI, file pensati per le macchine, formati “ottimizzati per i modelli”: per le funzionalità generative di Google valgono le regole della Search, senza aggiunte speciali, e finora nessun grande provider ha smentito. Il tempo speso a inseguire quelle promesse è tempo tolto alla densità informativa dei contenuti, che invece sposta i risultati in modo osservabile.
Le misure della presenza nelle risposte
Quante volte una tua pagina viene usata come fonte, quante volte il brand compare nella risposta che viene letta, quante volte è il nome che viene consigliato: sono tre misure distinte che devi imparare a conoscere e comprendere per verificare quanto davvero vale la tua visibilità.
Nell’AI Prompt Tracker di SEOZoom li leggi come Citation Rate, cioè la quota di scansioni in cui il dominio viene usato come fonte, Mention Rate, quelle in cui il brand viene nominato dentro il testo anche quando a nominarlo è una fonte terza, e Recommendation Rate, quelle in cui viene proposto come scelta adatta al bisogno espresso. Accanto trovi il tono con cui vieni citato, il ruolo competitivo che ti viene attribuito e l’origine della preferenza, se nasce dal merito o dal limite di un concorrente.
Un Citation Rate che sale mentre il Mention Rate sta fermo riporta alla titolarità dell’informazione: i tuoi contenuti alimentano le sintesi e il nome viaggia altrove, quindi il controllo va sul formato del dato e su chi lo sta trasportando al posto tuo. Molte menzioni e poche raccomandazioni descrivono un brand conosciuto e poco scelto, e le ipotesi da verificare riguardano le prove disponibili sul sito, il consenso esterno che favorisce altri nomi, oppure un paniere concentrato su domande informative. Anche un Recommendation Rate alto merita una verifica, perché può poggiare su poche formulazioni favorevoli, e lo stesso valore distribuito su intenti e motori diversi ha una qualità completamente differente. Nessuno di questi numeri diventa leggibile su una rilevazione sola: due sessioni consecutive danno risposte diverse, e quello che conta è la ricorrenza su un periodo abbastanza lungo da distinguere una tendenza da un sussulto.
Sopra i singoli tassi c’è poi la quota che occupi nelle risposte del tuo mercato, quella che chiamiamo Share of Model: è una lettura d’insieme e vale a condizione che dichiari il perimetro su cui la calcoli, perché lo stesso brand ottiene percentuali molto diverse cambiando categoria, tipo di domanda o motore.
Il peso di una menzione dentro le AI Overview
Una query digitata nella Search apre nell’assoluta maggioranza dei casi le AI Overview di Google, che vivono nella SERP e conservano tutto quello che sai già leggere: chiavi, volume, posizione organica, indirizzi accanto al testo generato. Se presidi bene una parola chiave hai in mano metà del lavoro, perché le pagine scelte per la sintesi nascono dallo stesso indice e dagli stessi segnali che governano il posizionamento classico. L’altra metà riguarda il rilievo che ottieni una volta dentro, e quella la SERP non la mostra.
Nella funzione AI Overview di SEOZoom la tabella delle keyword porta misure che il posizionamento tradizionale non ha. L’AI Rank stima la posizione della menzione al tuo sito nel box, e un valore pari a 1 significa che vieni citato per primo, nella collocazione di massima evidenza. Nella stessa riga trovi le Menzioni, cioè quante volte il dominio è stato usato come fonte per quella query, la Prima Menzione, che distingue le occasioni in cui sei tu ad aprire il testo, il Traffico Stimato generato lì dentro e separato dall’organico, e l’URL che Google ha effettivamente scelto, che spesso non è quello che avevi in mente. La tab AI Overview Gap ribalta la lettura e mostra le chiavi su cui i concorrenti vengono riconosciuti mentre tu manchi: è la lista più operativa che puoi avere per decidere dove intervenire.
Quando l’unità osservata è l’intento
ChatGPT, Gemini, Perplexity e AI Mode lavorano su richieste complete, dove il contesto modifica la domanda, la conversazione aggiunge vincoli e formulazioni distanti portano allo stesso problema. “Software per officine”, “programma per gestire una carrozzeria” e “come collegare preventivi, magazzino e fatture” indicano la stessa categoria di soluzione, quindi seguire una stringa precisa ne misura la stabilità mentre il mercato che quella stringa rappresenta resta fuori dall’osservazione. L’unità da monitorare diventa l’intento, e il paniere si costruisce sulle domande che pesano sul business: branded e unbranded, informative, comparative, reputazionali, decisionali, tenendo separato il set editoriale da quello commerciale perché mescolarli cambia il denominatore e falsa i tassi.
Nell’AI Prompt Tracker due schede pesano più delle altre. La Copertura Fan-Out misura quanto presidi già nelle SERP tradizionali il perimetro informativo che un prompt attiva, e una copertura debole segnala una situazione precisa: puoi entrare nel testo e lasciare scoperti i passaggi collegati, con il rischio di perdere stabilità nelle scansioni successive o di cedere spazio a un concorrente più completo. I prompt gap elencano invece le domande in cui i concorrenti ottengono citazioni e il tuo brand è assente, e ognuna è un’area in cui l’AI parla del tuo mercato senza nominarti.
Il ciclo di lavoro con SEOZoom
Il web che alimenta le risposte si muove di continuo, quindi l’AEO prende la forma di un ciclo e non di un intervento con una data di fine. A mano si può fare: apri un motore dopo l’altro, poni le stesse domande, salvi i testi e provi a metterli in fila. Ottieni una fotografia parziale, che cambia a ogni sessione e cede al primo confronto nel tempo, perché senza uno storico non distingui un movimento reale da un’oscillazione.
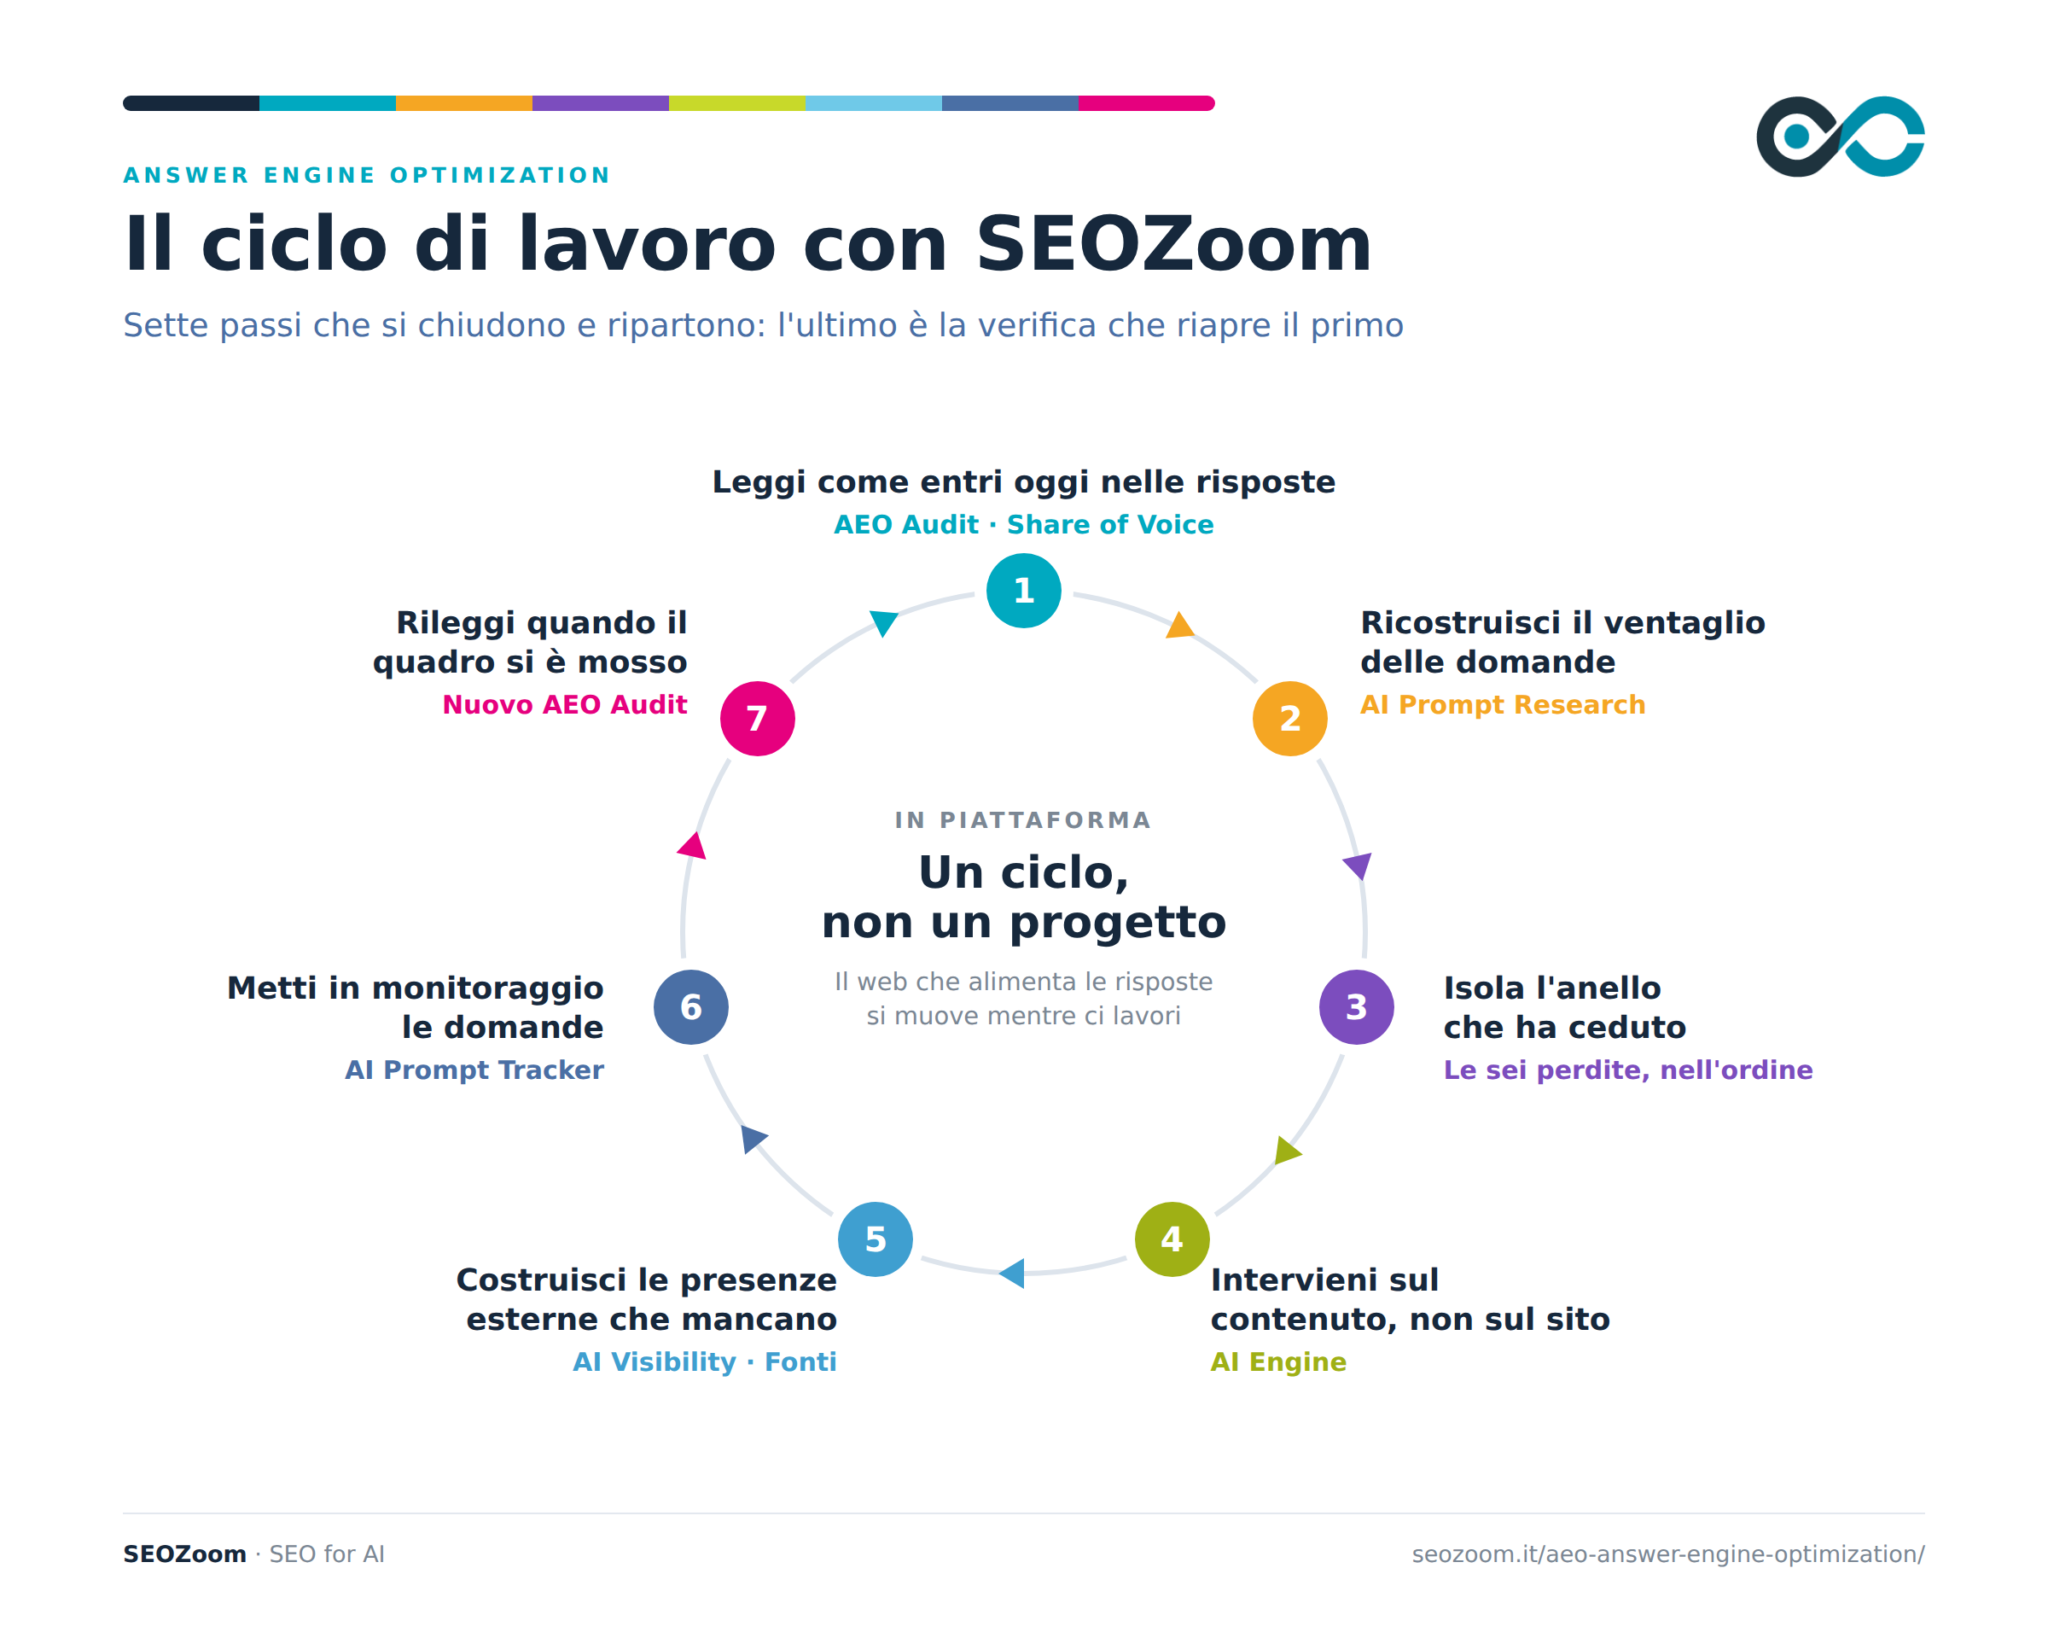
In piattaforma gli stessi passaggi vivono uno accanto all’altro, sullo stesso progetto.
- Leggi come entri oggi nelle risposte live. L’AEO Audit interroga ChatGPT, Gemini e Perplexity e restituisce qualità della presenza, riconoscimento del brand, sentiment, ruolo che i modelli ti assegnano e temi per cui vieni citato; nell’area Competizione di mercato trovi la Share of Voice, cioè la fetta di visibilità che detieni nelle risposte rispetto ai concorrenti che l’AI associa spontaneamente al tuo nome. I parametri con cui imposti l’analisi orientano le fonti che i motori vanno a cercare, quindi vanno scelti con cura e tenuti stabili fra un’analisi e l’altra.
- Ricostruisci il ventaglio delle domande che contano. Con AI Prompt Research ottieni gli ambiti che una richiesta attiva e la mappa dei contenuti che ti mancano, ambito per ambito, e da lì decidi che cosa scrivere invece di dedurlo dai volumi.
- Individua l’anello che ha ceduto. Percorri le sei perdite nell’ordine in cui il contenuto le incontra, dal documento che non arriva fra i candidati alla preferenza che va a un altro nome, senza riscrivere per ipotesi: le prime due si chiudono con una verifica, le altre quattro solo leggendo le risposte.
- Intervieni sul contenuto, non su tutto il sito. Rafforza i passaggi che devono reggere il prelievo e chiudi il perimetro del significato dove è aperto; con AI Engine verifichi la pertinenza di una pagina o di una bozza rispetto ai motori di risposta prima che esca.
- Costruisci le presenze esterne che ti mancano. Le due viste sulle fonti dell’AI Visibility ti consegnano l’elenco su cui lavorare, fra recensioni, community, trascrizioni e digital PR, e quell’elenco raramente coincide con i tuoi concorrenti commerciali.
- Metti in monitoraggio un portafoglio di domande. Con l’AI Prompt Tracker segui nel tempo citazioni, menzioni, raccomandazioni, tono e ruolo competitivo su ChatGPT, Gemini, Perplexity e Google AI Mode.
- Rileggi quando il quadro si è mosso. Un nuovo audit dopo gli interventi dice se la correzione ha funzionato o se hai lavorato sullo strato sbagliato, ed è l’unica verifica che chiude il ciclo.
Un AEO Audit fiacco descrive una presenza che oggi cede nelle risposte, e si corregge sui contenuti e sulle presenze esterne. Un GEO Audit fiacco descrive un’identità trascurata negli anni, e chiede un mestiere diverso, più lento.
Nessuno di questi passaggi si chiude una volta per tutte, perché il web da cui i motori pescano non sta fermo. Con il ciclo in piedi, però, te ne accorgi mentre succede, invece di scoprire un trimestre dopo che le risposte del tuo mercato si erano riscritte senza di te.


 Recensioni verificate su Trustpilot